
Một nút mua hàng khác màu chưa chắc khiến người dùng muốn mua hơn. Điều gì đang diễn ra trong tâm trí họ?
Bạn đổi nút “Mua ngay” từ xanh sang cam, thử 3 kiểu font cho tiêu đề rồi chỉnh thêm vài pixel để trang chủ thoáng mắt hơn. Vậy mà sau 3 tuần thử nghiệm, tỷ lệ chuyển đổi vẫn gần như đứng yên.
Điều này có thể bắt nguồn từ cách chúng ta hiểu về A/B testing. Khi quá tập trung vào việc giao diện nào đẹp hơn, bạn dễ bỏ qua cảm nhận của người đang sử dụng nó. Một thay đổi nhìn thấy được trên màn hình chưa chắc đã tác động đến tâm lý của họ.
Vậy A/B testing hoạt động thế nào, và vì sao có những chỉnh sửa nhỏ tạo ra khác biệt lớn, trong khi nhiều lần thay đổi lại chẳng mang đến kết quả?
A/B testing là gì?
A/B testing, hay thử nghiệm A/B, còn được gọi là split testing. Đây là phương pháp nghiên cứu thực nghiệm, trong đó 2 hoặc nhiều phiên bản của một nội dung số được hiển thị cho những nhóm người dùng khác nhau. Các nhóm được phân chia ngẫu nhiên và tham gia thử nghiệm trong cùng một thời điểm.
Nội dung được thử có thể là website, ứng dụng di động, landing page, email tiếp thị hay quảng cáo. Trong đó, A là phiên bản gốc (control), đóng vai trò đối chứng để đo tỷ lệ chuyển đổi hiện tại. Phiên bản B (variation/treatment) có một hoặc nhiều thay đổi so với A. Nếu muốn thử thêm C, D… cùng lúc, bạn có thể dùng hình thức A/B/n.
Tỷ lệ phản hồi và tỷ lệ chuyển đổi (conversion rate) của từng nhóm sau đó được ghi nhận. Các công cụ thống kê sẽ giúp xác định phiên bản nào thực sự hiệu quả hơn, thay vì chỉ nhìn vào chênh lệch trước mắt.

Phương pháp này vốn có nền tảng từ thử nghiệm có đối chứng (Randomized Controlled Trials), đã được sử dụng hàng trăm năm trong y học và nông nghiệp để đo hiệu quả của thuốc hay phương pháp canh tác. Đến đầu những năm 2000, internet và thương mại điện tử phát triển đã đưa nó vào quá trình xây dựng sản phẩm, tối ưu trải nghiệm người dùng tại Google, Amazon hay Booking.com.
Về cơ bản, A/B testing thay đổi cách một đội ngũ đưa ra quyết định. Họ có thể dựa vào bằng chứng thực nghiệm, thay vì cảm tính hay ý kiến của người có quyền lực nhất trong phòng họp, thường được gọi là HiPPO (Highest Paid Person’s Opinion). Đây chính là cách ra quyết định dựa trên dữ liệu (Data-Driven Decision Making).
A/B testing cũng cần được phân biệt với 2 hình thức khác:
- Split URL testing: Đưa người dùng sang một URL hoặc landing page khác để thử nghiệm cả một thiết kế lại.
- Multivariate testing (MVT): Thử đồng thời nhiều biến số như tiêu đề, hình ảnh và nút CTA để tìm ra tổ hợp tối ưu. Tuy nhiên, hình thức này cần lượng truy cập lớn hơn rất nhiều.
Vì sao thay giao diện chưa chắc thay được hành vi?
Nhiều nhà nghiên cứu trong lĩnh vực tối ưu tỷ lệ chuyển đổi (CRO) gọi A/B testing là thực nghiệm tâm lý học có quy mô lớn nhất thế giới. Mỗi năm, hàng trăm nghìn thử nghiệm được tiến hành, ghi nhận trực tiếp hành vi của hàng trăm triệu người dùng.
Nhìn từ góc độ này, mỗi biến thể đều là một cách tác động vào cảm nhận và hành vi. Màu nút hay font chữ là những gì bạn thay đổi trên giao diện, còn người dùng cảm thấy thế nào mới là điều cần tìm hiểu phía sau.
Người dùng có nhận ra bạn vừa thay đổi gì?
Hoạt động tối ưu CRO có thể được nhìn ở 3 cấp độ:
- Thử nghiệm/Thực thi: Thay đổi những yếu tố cụ thể về giao diện và trải nghiệm người dùng (UI/UX).
- Giả thuyết: Kiểm chứng các nguyên lý hành vi và những rào cản tâm lý.
- Hành trình khách hàng: Tìm hiểu động lực, các phân đoạn tâm lý và những điểm khiến người dùng bị mắc lại.
Nếu chỉ dừng ở cấp độ đầu tiên, bạn có thể sửa rất nhiều thứ mà vẫn chưa tác động được đến tâm trí người dùng. Theo nhiều chuyên gia trong ngành CRO, đây là lý do khiến hơn 75-90% thử nghiệm A/B không tạo ra khác biệt đáng kể.
Một công thức trong giới CRO diễn giải điều này như sau:
Tác động = Sự nhận thức × Sự liên quan × Lượng truy cập
Theo đó, nếu người dùng không nhận ra thay đổi, yếu tố “sự nhận thức” bằng 0 và tác động cũng bằng 0. Nói cách khác, ý tưởng có hay đến đâu cũng khó tạo ảnh hưởng nếu người sử dụng không cảm nhận được nó.
Đây chính là ý nghĩa của nguyên tắc “No Perception = No Impact”. Nó cũng lý giải vì sao phần lớn thử nghiệm vi mô, như đổi màu một nút nhỏ hay chỉnh nhẹ lề trang, không mang lại kết quả có ý nghĩa.
Bộ não thường chọn cách ít tốn sức
Theo lý thuyết tiến trình kép (Dual-Process Theory), não bộ có 2 hệ thống xử lý thông tin là System 1 và System 2.
System 1 hoạt động nhanh, tự động, thiên về cảm xúc và diễn ra vô thức. Hệ thống này làm việc liên tục nhưng tiêu tốn ít năng lượng, chịu trách nhiệm cho hơn 90-95% quyết định hàng ngày của chúng ta.
Trong khi đó, System 2 xử lý chậm hơn, dựa vào logic và sự chú ý có ý thức. Nó chỉ được kích hoạt khi gặp vấn đề phức tạp, đồng thời dễ rơi vào trạng thái “cạn pin” nhận thức (cognitive depletion).
Hầu hết người dùng lướt web và ra quyết định bằng System 1. Vì vậy, nếu biến thể chỉ bổ sung thông tin logic để họ phải suy nghĩ bằng System 2, họ sẽ thấy quá tải và rời đi. Những biến thể tạo ra mức cải thiện lớn thường tác động trực tiếp vào System 1, thông qua thiết kế trực quan, giá trị cảm xúc (Emotional Value Proposition) và các thiên kiến hành vi.
Tâm lý người dùng tạo ra khác biệt thế nào?
Hình ảnh gợi cảm xúc có thể khiến khách muốn mua hơn
Một ví dụ điển hình là thử nghiệm với mẫu giày Boxfresh Sparko tại một cửa hàng thời trang trực tuyến lớn ở Đức. Cửa hàng thử tối ưu khung mẫu trang, điều chỉnh khoảng trắng nhưng giữ nguyên hình ảnh sản phẩm. Kết quả, tỷ lệ thêm vào giỏ hàng tăng 8%.
Ở một hướng tiếp cận khác, hình ảnh sản phẩm được tái định vị dựa trên những giá trị cảm xúc của người dùng, như sự độc đáo hay địa vị. Lần này, tỷ lệ thêm vào giỏ hàng tăng tới 80%, doanh số thực tế tăng 40%, trong khi tỷ lệ trả hàng không tăng.
Cùng một sản phẩm, nhưng cách tác động vào cảm nhận của người xem đã mang lại những kết quả khác nhau.
Cảm giác được lựa chọn khiến việc điền form dễ chịu hơn
Khi muốn tăng tỷ lệ hoàn thành form đặt phòng, chuỗi khách sạn Van Der Valk tại Hà Lan thử thay đổi cách đánh dấu các trường thông tin. Thay vì chỉ ra những trường bắt buộc phải điền như thông thường, họ chuyển sang đánh dấu các trường tự chọn.
Cách thể hiện này khiến người dùng có cảm giác được tự do lựa chọn hơn, thay vì bị yêu cầu phải làm một việc. Kết quả, tỷ lệ hoàn thành form tăng 24.7%. Điều được thay đổi là cách gọi tên, nhưng điều chịu tác động lại là cảm giác của người đang điền thông tin.
Một hạn chót có thật tạo cảm giác cấp bách
Một doanh nghiệp B2B bán máy photo và thiết bị văn phòng tổ chức chương trình ưu đãi kéo dài 2 ngày. Bên cạnh email thông báo giảm giá thông thường, họ thử thêm một phiên bản nhấn mạnh đồng hồ đếm ngược 48 giờ.
Doanh thu từ phiên bản có đồng hồ tăng tới 136% so với bản gốc. Trong trường hợp này, cảm giác cấp bách được gắn với thời hạn thực tế của chương trình.
Ảnh lớn chưa chắc khiến sản phẩm có giá hơn
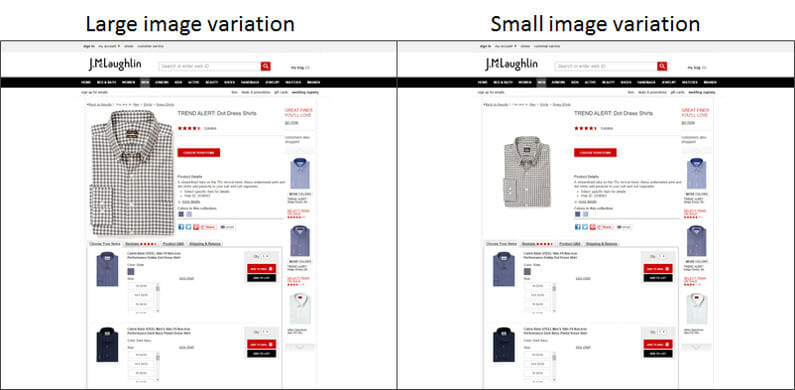
Theo nghiên cứu của CXL trên 2.982 người tham gia, phản ứng với kích thước ảnh còn phụ thuộc vào loại sản phẩm được giới thiệu.
Với sản phẩm mang tính trải nghiệm như áo sơ mi nam, ảnh nhỏ kết hợp nhiều khoảng trắng khiến người xem cảm nhận giá trị cao hơn so với ảnh lớn chiếm hết màn hình. Nhưng với sản phẩm thiên về thông số kỹ thuật như ổ cứng máy tính, ảnh lớn lại làm tăng định giá cảm nhận. Người tham gia thậm chí sẵn sàng trả thêm 15 USD.
Như vậy, cùng là điều chỉnh kích thước ảnh, phản ứng của người dùng có thể đi theo những hướng khác nhau.
B cao hơn A, đã chắc là “thắng”?
Một phiên bản có tỷ lệ chuyển đổi cao hơn chưa đủ để giải thích vì sao nó thắng. Để biết chênh lệch có thực sự đến từ thay đổi được thử nghiệm, chúng ta cần đến thống kê. Bạn không nhất thiết phải trở thành nhà thống kê học, nhưng cần hiểu một số khái niệm để tránh đọc nhầm kết quả.
Phân biệt khác biệt thực sự với sai số ngẫu nhiên
Mỗi thử nghiệm bắt đầu với 2 giả thuyết đối lập. Giả thuyết không (H0) cho rằng A và B không có khác biệt thực sự; chênh lệch quan sát được chỉ đến từ sai số ngẫu nhiên. Trong khi đó, giả thuyết đối (H1) cho rằng có khác biệt thực sự do thay đổi được đưa vào thử nghiệm gây ra.
Để đánh giá kết quả, chúng ta sử dụng p-value. Đây là xác suất nhận được mức chênh lệch như đã quan sát, hoặc lớn hơn, nếu H0 đúng.
Ngưỡng ý nghĩa thường được đặt ở 0.05, tương ứng với mức tin cậy 95%. Khi mức cải thiện có p-value nhỏ hơn 0.05, bạn có thể bác bỏ H0 và kết luận sự cải thiện có ý nghĩa thống kê.
Ít người tham gia thì khó nhìn thấy khác biệt
Độ mạnh thống kê (statistical power) là khả năng một thử nghiệm phát hiện được khác biệt thực sự khi khác biệt ấy tồn tại. Mức thường được sử dụng trong ngành là từ 80% trở lên.
Có 2 kiểu sai lầm cần chú ý khi đọc kết quả:
- Sai lầm loại I: Bạn kết luận B tốt hơn A, trong khi thực tế hai phiên bản không khác nhau.
- Sai lầm loại II: B thực sự tốt hơn, nhưng thử nghiệm không phát hiện được vì kích thước mẫu chưa đủ.
Điều này liên quan đến MDE (Minimum Detectable Effect) – mức chênh lệch nhỏ nhất về tỷ lệ chuyển đổi mà bạn muốn phát hiện. MDE càng nhỏ, lượng mẫu cần có càng lớn.
Vì vậy, một trang có ít lượt truy cập dễ rơi vào tình trạng thiếu mẫu (underpowered tests). Khi đó, mức chênh lệch cần thiết để phát hiện tín hiệu trở nên quá lớn. Bạn có thể chạy thử nghiệm nhiều tháng mà vẫn chưa đạt ý nghĩa thống kê.
Cách đọc kết quả cũng có sự khác nhau
Với cách tiếp cận Frequentist, bạn cần thu thập đủ lượng mẫu cố định đã tính trước, sau đó mới tính p-value và đưa ra kết luận. Cách này không cho phép kết luận sớm.
Trong khi đó, Bayesian liên tục cập nhật xác suất thắng hoặc thua dựa trên dữ liệu thu thập được. Cách tiếp cận này phù hợp hơn với những quyết định kinh doanh cần sự linh hoạt.
Bắt đầu một thử nghiệm A/B như thế nào?
Một chương trình A/B testing hoàn chỉnh cần 5 thành phần: bản gốc, biến thể, hệ thống chỉ số, cách phân luồng lưu lượng và giả thuyết cần kiểm chứng. Để chuẩn bị và sử dụng những thành phần này, bạn có thể đi theo 6 bước sau.
Tìm hiểu người dùng đang gặp khó khăn ở đâu
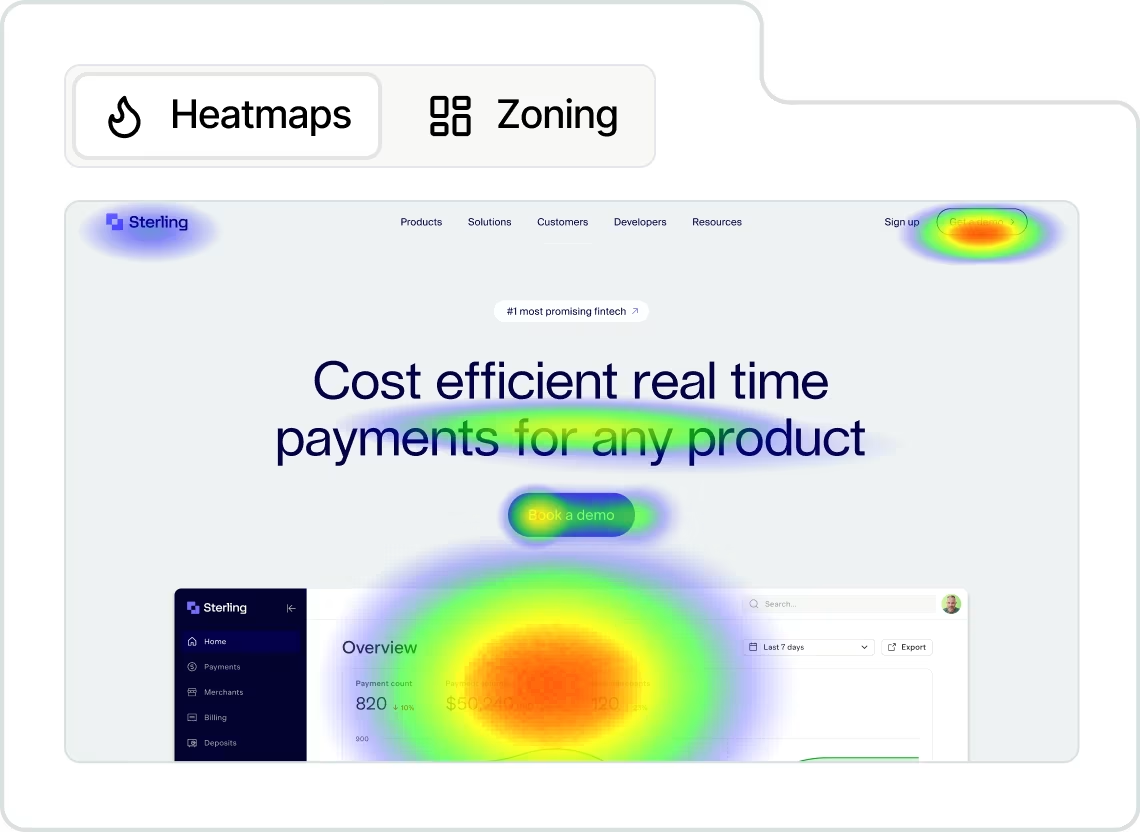
Ý tưởng thử nghiệm cần bắt đầu từ dữ liệu về người dùng. Với dữ liệu định lượng, bạn có thể dùng Google Analytics/GA4 để tìm những trang có tỷ lệ thoát hoặc bỏ dở cao. Heatmap, click map và scroll map giúp nhận biết họ tương tác với phần nào, hoặc bỏ qua phần nào trên trang.
Bên cạnh đó, dữ liệu định tính giúp tìm hiểu những rào cản phía sau hành vi. Bạn có thể thu thập thông tin từ khảo sát người dùng, phỏng vấn exit-intent khi họ chuẩn bị rời trang, thử nghiệm 5 giây và kiểm tra tính khả dụng. Đánh giá của chuyên gia dựa trên tâm lý học nhận thức cũng giúp làm rõ những rào cản này.
Từ điều quan sát được, đặt ra giả thuyết
Sau khi có dữ liệu, bạn cần xác định thay đổi nào có thể tác động đến hành vi, và vì sao. Đây là cách tránh “garbage testing” – đưa những thay đổi ngẫu nhiên vào thử nghiệm mà không có cơ sở.
Một giả thuyết rõ ràng có thể được trình bày theo công thức: “Nếu áp dụng [thay đổi X], thì [chỉ số Y] sẽ thay đổi [mức độ Z], bởi vì [lý do tâm lý/hành vi W]”.
Chẳng hạn, bạn có thể đặt giả thuyết: “Người dùng bỏ dở form đăng ký ở bước 2 vì lo lắng về bảo mật dữ liệu cá nhân. Nếu bổ sung biểu tượng chứng nhận uy tín ngay cạnh nút Submit, tỷ lệ hoàn thành form sẽ tăng 15%.”
Trong ví dụ này, biểu tượng chứng nhận là thay đổi được đưa vào thử nghiệm. Còn điều cần kiểm chứng phía sau là giả thuyết về nỗi lo bảo mật khiến người dùng bỏ dở form.
Chọn thử nghiệm cần làm trước
Để sắp xếp thứ tự ưu tiên, bạn có thể tham khảo khung PIE, gồm Potential (tiềm năng cải thiện), Importance (tầm quan trọng của trang) và Ease (độ dễ triển khai). Một lựa chọn khác là ma trận Tác động – Chi phí.
Nguyên tắc chung là ưu tiên những thử nghiệm có tác động cao, kể cả khi cần nhiều công sức thực hiện (bold testing). Những thay đổi tốn chi phí nhưng tác động thấp cũng thuộc nhóm “garbage testing” cần tránh.
Chuẩn bị biến thể và cách đo lường
Sau khi chọn được giả thuyết, bạn bắt đầu thiết kế và lập trình biến thể. Sự khác biệt cần đủ rõ để người dùng có thể nhận thấy, nếu không bạn lại gặp vấn đề “No Perception = No Impact” ở trên.
Trước khi chạy, cần kiểm thử QA trên mọi trình duyệt, thiết bị và độ phân giải màn hình. Một lỗi vỡ khung có thể làm méo dữ liệu thử nghiệm.
Hệ thống đo lường cần có 3 nhóm chỉ số:
- Chỉ số chính (Primary Metric/OMTM): Dùng để quyết định phiên bản thắng, chẳng hạn tỷ lệ hoàn thành đơn hàng.
- Chỉ số phụ: Theo dõi những bước trung gian, như tỷ lệ nhấp Add-to-Cart hoặc tỷ lệ cuộn trang.
- Chỉ số bảo vệ (Guardrail Metrics): Giúp đảm bảo thử nghiệm không gây hại cho trải nghiệm tổng thể. Các chỉ số có thể gồm tỷ lệ hoàn trả hàng, tỷ lệ hủy đăng ký, tốc độ tải trang và doanh thu trên mỗi người dùng (ARPU).
Bạn cũng cần chuẩn bị cách phân luồng ngẫu nhiên giữa A và B. Cookie hoặc User ID giúp một người khi quay lại vẫn thấy đúng phiên bản đã được phân từ đầu.
Cho thử nghiệm đủ thời gian
Thời gian chạy tối thiểu cần ở mức 14-21 ngày, bao phủ cả ngày thường lẫn cuối tuần. Điều này giúp hạn chế nhiễu do thói quen mua sắm thay đổi theo ngày.
Nếu p-value xuống dưới 0.05 trong vài ngày đầu, bạn cũng đừng vội dừng thử nghiệm. Những tín hiệu tích cực ban đầu chưa phải lý do để bỏ qua lượng mẫu và thời gian cần thiết.
Đọc kết quả và lưu lại điều đã học
Một thử nghiệm có thể cho kết quả hòa khi nhìn tổng thể. Tuy nhiên, khi phân tích sâu hơn theo từng phân đoạn, bạn đôi khi sẽ thấy biến thể thắng rõ ở nhóm dùng điện thoại hoặc macOS.
Dù kết quả thắng hay thua, các bài học cần được lưu vào kho tri thức chung để đội sản phẩm và marketing cùng sử dụng. Một biến thể chưa tạo được mức cải thiện mong muốn vẫn có thể giúp bạn hiểu thêm về khách hàng.
Thử nghiệm rồi, vì sao vẫn có thể hiểu nhầm?
Những ngày đầu chưa nói lên tất cả
Việc kiểm tra kết quả mỗi ngày và tắt thử nghiệm ngay khi p-value xuống dưới 0.05 được gọi là peeking problem. Cách làm này khiến tỷ lệ sai lầm loại I tăng lên tới 30-50%.
Bên cạnh đó, người dùng có thể phản ứng với sự mới lạ của giao diện. Khách cũ nhấp vào B vì thấy khác với thường ngày, khiến chỉ số tăng trong những ngày đầu rồi giảm dần. Đây là hiệu ứng mới mẻ (novelty effect).
Chiều ngược lại cũng có thể xảy ra. Những khách hàng đã quen với giao diện cũ cảm thấy khó chịu khi nó bị thay đổi, khiến chỉ số của B giảm mạnh lúc đầu. Hiện tượng này được gọi là hiệu ứng chống đối (primacy effect).
Thắng nhiều lần nhỏ, hiệu suất vẫn chạm trần
Một thiết kế đã lạc hậu có thể tiếp tục được chỉnh màu nút, khoảng cách chữ và nhiều chi tiết khác. Dù một số thay đổi thắng trong thử nghiệm, hiệu suất của trang vẫn chạm trần.
Đây chính là bẫy cực đại địa phương (local maxima trap). Để tránh mắc lại ở đó, bạn cần kết hợp những thử nghiệm vi mô với các lần thử thay đổi lớn và táo bạo hơn.

Khách nhấp nhiều hơn chưa chắc mua nhiều hơn
Một biến thể có thể tăng 30% tỷ lệ nhấp nút, nhưng đồng thời làm giảm chất lượng khách hàng tiềm năng (lead) và tổng doanh thu thực tế. Nếu chỉ nhìn vào bước tương tác ban đầu, bạn rất dễ bỏ sót những gì diễn ra ở cuối hành trình mua hàng.
Vì vậy, bên cạnh chỉ số nhấp chuột, bạn cần theo dõi song song các chỉ số bảo vệ và ARPU.
Khách mùa sale có thể hành xử khác ngày thường
Các đợt megasale như Black Friday hay Tết có thể làm thay đổi hành vi mua sắm thông thường, từ đó gây nhiễu kết quả A/B testing. Một phiên bản thắng trong đợt sale chưa chắc tiếp tục hiệu quả khi chương trình kết thúc.
Bối cảnh mùa vụ vì vậy cũng cần được tính đến khi diễn giải kết quả.
Tác động vào tâm lý cũng có thể phản tác dụng
Theo nghiên cứu từ tiến sĩ Brian Cugelman và CXL, việc tạo sự khan hiếm giả hoặc ép buộc thông tin trong thử nghiệm A/B có thể phản tác dụng. Khi nhận ra mình bị thao túng, người dùng dễ trở nên hoài nghi và rời bỏ thương hiệu về lâu dài.
Điều khó nhận biết là tỷ lệ chuyển đổi ngắn hạn vẫn có thể tăng. Báo cáo cho thấy một biến thể đang thắng, trong khi tác động tiêu cực phía sau lại bị bỏ sót.
Với nút “Mua ngay” ở đầu bài, điều cần tìm hiểu vẫn là người dùng có nhận thấy thay đổi hay không, và nó tác động thế nào đến cảm nhận của họ. Đây cũng là cách nhìn A/B testing như một công cụ đo lường hành vi tâm lý, vượt ra ngoài việc lập trình hay thiết kế giao diện.
Để những bài học ấy có cơ sở, thử nghiệm cần được chạy đủ thời gian, đủ mẫu và phân tích bằng thống kê nghiêm ngặt. Doanh thu tăng thêm từ một biến thể thắng là một kết quả, còn mục tiêu lớn hơn của chương trình vẫn là tích lũy hiểu biết về khách hàng, qua cả những lần thắng lẫn những lần thua.