
Technical SEO là hạ tầng quyết định một website có được công cụ tìm kiếm nhìn thấy, đọc đúng và đưa vào kết quả hay không. Nó xử lý phần phía sau giao diện: máy chủ, cấu trúc đường dẫn, chỉ dẫn cho bot, tốc độ, khả năng hiển thị nội dung và dữ liệu có cấu trúc. Một website có bài viết tốt nhưng bị chặn crawl hoặc gắn noindex sai vẫn gần như vô hình trên Google. Bài viết này trình bày các thành phần cốt lõi, quy trình audit, thứ tự sửa lỗi, cách báo cáo và yêu cầu của AI search. Mục tiêu là giúp bạn hiểu technical SEO như một hệ thống vận hành, không phải danh sách thuật ngữ rời rạc.
Technical SEO là gì?

Technical SEO là tập hợp các tối ưu hóa hạ tầng giúp công cụ tìm kiếm crawl, render và index website hiệu quả.
Nói đơn giản, technical SEO dọn đường để bot tìm thấy trang, tải nội dung, hiểu quan hệ giữa các URL và lưu phiên bản phù hợp. Phạm vi này gồm máy chủ, kiến trúc website, robots directives, canonical và structured data; nó không trực tiếp viết bài như on-page SEO hay xây backlink như off-page SEO.
Ba lớp bổ trợ nhưng không thay thế nhau. Nội dung tốt vẫn không xuất hiện trên SERP nếu trang mang noindex. Backlink mạnh cũng khó nâng hạng URL mà Googlebot không thể crawl. Technical SEO vì thế là tầng nền: nó không tạo ra toàn bộ giá trị SEO, nhưng quyết định giá trị từ nội dung và liên kết có được ghi nhận hay không. Lớp kỹ thuật giữ cánh cửa tìm kiếm luôn mở đúng cách.
Technical SEO cơ bản
Trước khi đi vào cấu hình, bạn cần trả lời hai câu hỏi: technical SEO khó đến đâu, và còn giá trị khi người dùng tìm kiếm bằng AI hay không? Câu trả lời giúp phân biệt việc có thể tự chuẩn hóa với phần cần chuyên gia, đồng thời cho thấy nền tảng kỹ thuật vẫn giữ vai trò trung tâm khi hình thức tìm kiếm thay đổi.
Technical SEO có phức tạp không?
Độ phức tạp phụ thuộc vào loại lỗi. Sitemap, robots.txt, HTTPS, canonical và redirect thường xử lý được bằng CMS cùng công cụ audit. Mức trung cấp gồm crawl budget và structured data; mức nâng cao mới đòi hỏi hiểu hybrid rendering, edge SEO hoặc log máy chủ.
Với phần lớn website, khoảng 80% lỗi phổ biến có thể được phát hiện qua Google Search Console và Ahrefs rồi sửa theo quy trình chuẩn, không cần lập trình sâu. Thứ tự đúng là bảo đảm bot truy cập và index trước, sau đó mới tối ưu hiệu suất và lớp nâng cao.
Technical SEO có quan trọng với AI search không?
Có. Google AI Overviews, Bing Copilot và hệ thống dựa trên mô hình ngôn ngữ vẫn cần crawler thu thập dữ liệu. Website không thể crawl thì nội dung không được đọc, lập chỉ mục hay dùng làm nguồn cho câu trả lời AI.
AI search còn tăng giá trị của HTML dễ truy cập, URL sạch và structured data. Chúng giúp hệ thống nhận ra sản phẩm, bài viết hay tổ chức thay vì đoán từ văn bản. Khi website thiếu dữ liệu có cấu trúc hoặc giấu nội dung chính sau JavaScript khó render, mô hình khó xác định đúng thực thể và ít chọn trang cho câu trả lời tổng hợp hơn.
Vai trò của Technical SEO đối với website
Technical SEO kiểm soát ba điều kiện tối thiểu để website cạnh tranh trên SERP:
- Discoverability: bot tìm thấy, crawl và index đúng URL.
- Performance: trang tải nhanh, phản hồi tốt và ổn định.
- Structured data: Google hiểu nội dung và có cơ sở hiển thị rich results.
Nếu một điều kiện hỏng, công sức ở lớp khác có thể không được ghi nhận. Một crawl trap khiến Googlebot đi qua hàng nghìn URL bộ lọc vô giá trị: ngân sách crawl bị tiêu hao, trang quan trọng được ghé ít hơn và nội dung mới cập nhật chậm. Lỗi càng để lâu càng lan theo URL, template và liên kết phát sinh. Technical SEO vì thế không chỉ hỗ trợ thứ hạng mà còn ngăn chi phí sửa chữa tăng khi website mở rộng. Nó giúp nội dung và backlink phát huy giá trị bền vững.
Các yếu tố và thành phần quan trọng trong Technical SEO
Technical SEO không nằm ở một thẻ hay công cụ. Nó gồm kiến trúc, crawl–render–index, chỉ dẫn bot, kiểm soát trùng lặp, tốc độ, mobile, schema, sitemap, bảo mật và trải nghiệm. Mỗi phần giải một rủi ro, nhưng phải nhất quán vì cấu hình đúng ở nơi này vẫn có thể bị cấu hình khác vô hiệu hóa.
Cấu trúc website (Site Architecture) và Điều hướng (Navigation)
Cấu trúc website quyết định cách người dùng và bot đi qua nội dung. Mô hình rõ thường là Homepage → Category → Subcategory → Page, với URL phản ánh phân cấp. Trang quan trọng nên nằm trong ba lần nhấp từ homepage để giảm crawl depth và nhận PageRank nội bộ.
Các nguyên tắc nền tảng gồm:
- Dùng phân cấp gọn, danh mục rõ, tránh nhiều đường dẫn cho cùng nội dung.
- Đặt internal link theo ngữ cảnh, không chỉ ở sidebar hoặc footer.
- Bảo đảm mỗi trang giá trị nhận ít nhất một liên kết có thể crawl.
Trang không nhận internal link là orphan page; Googlebot khó tìm thấy dù nội dung tốt. Ngược lại, bộ lọc vô hạn tạo crawl trap, kéo bot vào chuỗi URL vô giá trị và làm suy yếu luồng crawl toàn site.
Crawl, Render và Index
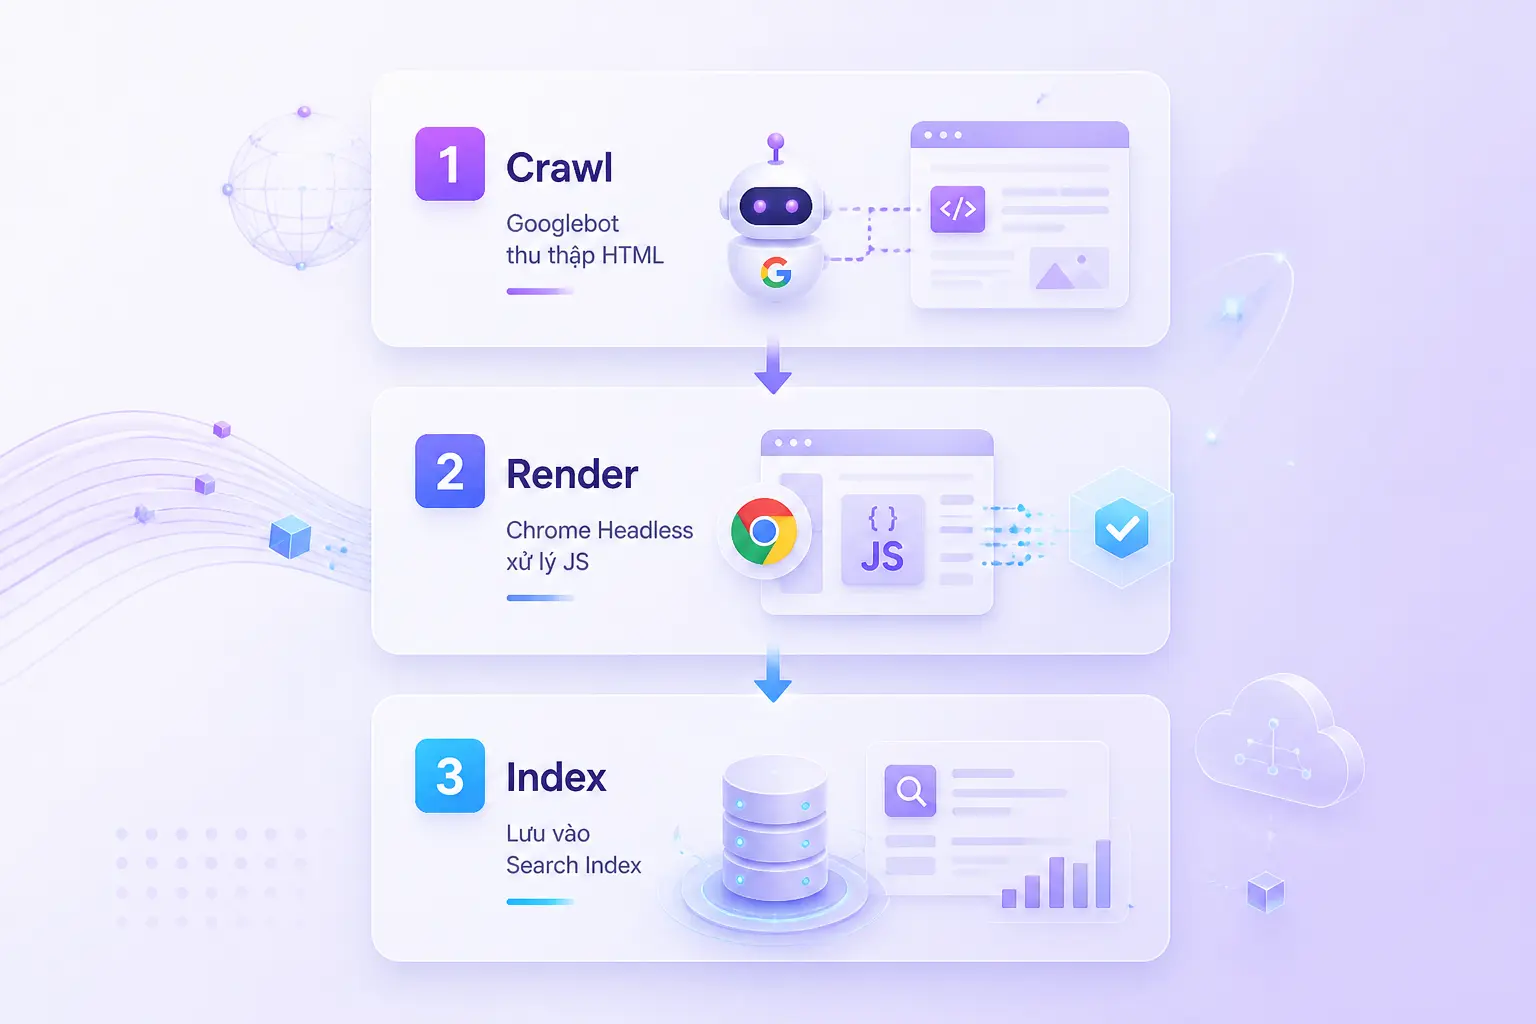
Mỗi URL phải đi qua ba giai đoạn trước khi có thể xuất hiện trên SERP:
- Crawl: Googlebot phát hiện URL qua liên kết hoặc sitemap, gửi yêu cầu và tải HTML. Cách bot phân bổ lượt truy cập được giới hạn bởi crawl budget.
- Render: Google dùng Chrome Headless để chạy tài nguyên và dựng nội dung. JavaScript thường nằm trong hàng đợi riêng, nên nội dung chỉ có sau khi chạy JS có thể bị index chậm từ vài ngày đến vài tuần. Website nặng JavaScript có thể cần dynamic hoặc hybrid rendering.
- Index: Google đánh giá phiên bản đã dựng và quyết định có lưu URL vào chỉ mục hay không.
Trạng thái “Crawled – not indexed” trong Google Search Console nghĩa là bot đã tới trang nhưng Google chưa thấy đủ lý do để index. Nguyên nhân thường là nội dung mỏng, trùng lặp hoặc soft 404. Hãy phân loại URL trong báo cáo Index Coverage, thay vì gửi index lại hàng loạt mà chưa sửa nguyên nhân.
Robots directives và File robots.txt
Robots directives trả lời hai câu hỏi khác nhau: bot có được crawl URL không, và URL có được xuất hiện trên SERP không. File robots.txt dùng để ngăn crawl các khu vực không cần bot truy cập, chẳng hạn giỏ hàng, trang đăng nhập hoặc tìm kiếm nội bộ.
User-agent: *
Disallow: /cart/
Disallow: /internal-search/
Meta robots noindex lại dùng cho trang người dùng vẫn cần mở nhưng không nên có trong chỉ mục, như trang cảm ơn hoặc môi trường staging.
- Dùng
Disallowđể tiết kiệm lượt crawl ở URL không cần đọc. - Dùng
noindexđể loại URL khỏi kết quả tìm kiếm sau khi bot crawl lại. - Không xem robots.txt là lớp bảo mật.
Một URL bị Disallow vẫn có thể được Google biết đến qua backlink và xuất hiện với thông tin rất ít, vì bot không được tải HTML để đọc noindex. Nội dung cần bảo mật phải được kiểm soát bằng xác thực, không phải robots.txt.
Canonicalization
Khi cùng nội dung tồn tại ở nhiều địa chỉ — URL có tham số, bản in hoặc khác dấu gạch chéo cuối — thẻ canonical cho Google biết phiên bản chính. Nhờ đó, tín hiệu liên kết không bị chia nhỏ.
Canonical là gợi ý, không phải mệnh lệnh. Google có thể chọn URL khác nếu thẻ mâu thuẫn với internal links hoặc sitemap. Vì vậy, liên kết nội bộ, sitemap và canonical phải cùng trỏ về một địa chỉ. Mỗi trang nên có self-referencing canonical, tức trỏ về chính nó, để phòng tham số tạo bản trùng. WordPress thường sinh thẻ tự động, nhưng vẫn cần kiểm tra sau khi đổi cấu trúc URL. Tín hiệu nhất quán giúp Google ít phải tự suy đoán phiên bản chính.
Thin và Duplicate Content
Thin content là trang có quá ít giá trị riêng; duplicate content là nhiều URL mang nội dung gần giống nhau. Cả hai làm loãng chỉ mục và khiến Google khó chọn trang để xếp hạng. Dấu hiệu thường là category rỗng, tag page không có mô tả hoặc văn bản mẫu lặp lại.
Cách xử lý tùy mục đích:
- Bổ sung nội dung nếu trang có nhu cầu tìm kiếm thật.
- Hợp nhất trang gần giống và redirect về bản mạnh nhất.
- Dùng canonical hoặc noindex khi URL cần tồn tại nhưng không nên xếp hạng.
Ở website thương mại điện tử, bộ lọc màu, cỡ và giá có thể sinh hàng trăm URL trùng. Nếu không kiểm soát bằng canonical hoặc robots.txt, chúng tiêu hao crawl budget và phân tán PageRank khỏi danh mục chính.
Tốc độ tải trang
Tốc độ tải ảnh hưởng trải nghiệm và là tín hiệu xếp hạng. Nguyên nhân thường là JavaScript chặn render, ảnh nặng, thiếu bộ nhớ đệm, nhiều HTTP request và không có CDN. Biện pháp nền tảng gồm:
- Minify CSS/JavaScript; trì hoãn tài nguyên chưa cần.
- Dùng WebP và lazy-load ảnh dưới màn hình đầu.
- Bật browser caching, HTTP/2 và CDN.
- Loại bỏ tài nguyên thừa, không chỉ nén chúng.
TTFB là thời gian từ lúc gửi yêu cầu đến khi nhận byte đầu, phản ánh lớp máy chủ. Mức trên 600 mili giây thường gợi ý hosting yếu, thiếu CDN hoặc truy vấn cơ sở dữ liệu chậm. Máy chủ phản hồi lâu làm nguy cơ timeout tăng, tần suất crawl giảm và nội dung mới cập nhật chậm hơn trên SERP. Đo trước, sau sửa để xác định can thiệp thật sự hiệu quả.
Đảm bảo website thân thiện với thiết bị di động
Google áp dụng mobile-first indexing: phiên bản mobile là cơ sở để crawl và đánh giá. Website không responsive hoặc thiếu nội dung trên màn hình nhỏ có thể mất hạng dù bản desktop đầy đủ.
Một phiên bản mobile tốt cần:
- Thiết kế responsive, khai báo viewport đúng.
- Nội dung và structured data tương đương desktop.
- Nút đủ lớn, khoảng cách chạm hợp lý, font dễ đọc.
- Không chặn CSS hoặc JavaScript cần để render.
Lỗi thường gặp là chữ nhỏ, nút đặt sát nhau hoặc nội dung ẩn trong accordion. Google Mobile-Friendly Test kiểm tra từng URL; báo cáo Mobile Usability trong GSC nhận diện lỗi trên nhiều trang.
Technical SEO Schema / Structured Data
Structured data là lớp nhãn giúp Google hiểu loại thực thể. Schema Markup thường viết bằng JSON-LD để mô tả Product, Article, FAQPage, BreadcrumbList, Review hoặc Organization. Dữ liệu hợp lệ tạo cơ hội nhận rich results trên SERP.
Nguyên tắc triển khai gồm:
- Chọn loại cụ thể nhất trên Schema.org.
- Bảo đảm dữ liệu đánh dấu khớp với nội dung người dùng nhìn thấy.
- Không thêm schema cho thông tin bị ẩn hoặc không tồn tại trên trang.
- Có thể dùng nhiều schema nếu chúng mô tả đúng thực thể liên quan.
Trước production, kiểm tra bằng Google Rich Results Test và Schema Markup Validator. Sau triển khai, theo dõi Search Appearance trong GSC để biết rich results có được ghi nhận, tạo impression hay phát sinh lỗi. Một trang sản phẩm, chẳng hạn, có thể dùng Product, Review và BreadcrumbList nếu từng khối dữ liệu phản ánh đúng thông tin khách hàng đang thấy.
Hreflang và tối ưu đa ngôn ngữ
Hreflang mô tả quan hệ ngôn ngữ–quốc gia giữa các phiên bản, giúp Google đưa đúng bản cho người dùng và hạn chế URL đa ngôn ngữ cạnh tranh nhau.
<link rel="alternate" hreflang="vi" href="https://example.com/vi/trang/">
<link rel="alternate" hreflang="en" href="https://example.com/en/page/">
<link rel="alternate" hreflang="x-default" href="https://example.com/page/">
Có thể khai báo qua HTML, HTTP header hoặc XML sitemap. Mọi phiên bản phải trỏ lại nhau và có x-default. Lỗi phổ biến là thiếu return tag hoặc dùng vn thay vì vi. Kiểm tra International Targeting trong GSC hoặc Ahrefs Site Audit để tìm cặp không đối ứng. Với website phục vụ nhiều quốc gia, kết hợp mã ngôn ngữ và vùng như en-US hoặc en-GB để điều hướng phiên bản theo thị trường.
Kiểm tra website để tìm Dead Links và Broken Links
Broken link dẫn tới tài nguyên không hoạt động, thường trả 404. Với liên kết nội bộ, lỗi này cắt đường đi của người dùng và Googlebot, đồng thời làm thất thoát PageRank. Càng nhiều điểm gãy, hiệu quả crawl càng thấp.
Quy trình xử lý nên tập trung vào tác động:
- Dùng Ahrefs Site Audit hoặc Screaming Frog để lấy URL lỗi, status và trang nguồn.
- Ưu tiên lỗi trên homepage, category và trang có traffic cao.
- Cập nhật link hoặc redirect 301 nếu URL cũ còn giá trị.
- Xóa link nếu không có đích thay thế phù hợp.
Trang 404 đẹp chỉ cải thiện trải nghiệm; nó không khôi phục luồng crawl hay tín hiệu đã mất.
Submit Sitemap lên Google và Xác thực XML Sitemaps
XML Sitemap liệt kê URL ưu tiên để Googlebot phát hiện nhanh, nhất là khi internal linking chưa hoàn thiện. Sitemap không bảo đảm index, nhưng cho Google biết trang tồn tại.
- Tạo XML sitemap bằng Yoast, Rank Math hoặc deployment pipeline.
- Chỉ đưa vào URL canonical, indexable, trả 200; loại trang noindex, redirect hoặc lỗi.
- Gửi sitemap trong Google Search Console tại mục Sitemaps.
- Theo dõi lỗi và tỷ lệ giữa URL submitted với URL indexed.
Sitemap và canonical phải cùng chỉ một địa chỉ. Nếu số trang đã gửi cao nhưng số được index thấp, nguyên nhân thường là chất lượng, trùng lặp hoặc crawlability. Hãy sửa nguồn gốc thay vì gửi lại tệp.
Noindex Tag và Category Pages
Noindex kiểm soát URL xuất hiện trên SERP. Nó hợp với trang hữu ích cho người dùng nhưng không có giá trị tìm kiếm riêng, như kết quả nội bộ, trang cảm ơn, tag page hoặc staging.
- Đặt trong
<meta name="robots" content="noindex">hoặc X-Robots-Tag. - Giữ URL crawlable để Googlebot đọc chỉ dẫn.
- Noindex chỉ có hiệu lực sau lần crawl tiếp theo.
Không nên mặc định noindex category page mỏng. Danh mục có thể xếp hạng từ khóa rộng và dẫn người tìm kiếm vào nhóm nội dung. Noindex làm mất cửa vào organic search. Nếu có nhu cầu thật, hãy bổ sung mô tả, sản phẩm hoặc liên kết hữu ích.
HTTPS và độ bảo mật của website
HTTPS là tín hiệu xếp hạng và giúp tránh cảnh báo kết nối không an toàn. Khi chuyển từ HTTP, cần cài SSL/TLS, redirect 301 URL cũ sang HTTPS và cập nhật internal links để tránh chuỗi chuyển hướng.
Các điểm phải kiểm tra gồm:
- Mọi biến thể HTTP, www và non-www dẫn tới một bản chuẩn.
- Ảnh, script và stylesheet không tải qua HTTP để tránh mixed content.
- Canonical, hreflang và sitemap đều dùng URL HTTPS.
- Internal links dùng absolute URL nhất quán.
Thẻ Security trong Chrome DevTools giúp tìm mixed content. Sau chuyển đổi, theo dõi property HTTP và HTTPS trong GSC để so sánh index, tìm redirect lỗi và xác nhận tín hiệu đã dịch chuyển.
Trải nghiệm người dùng (Performance & UX) và Core Web Vitals
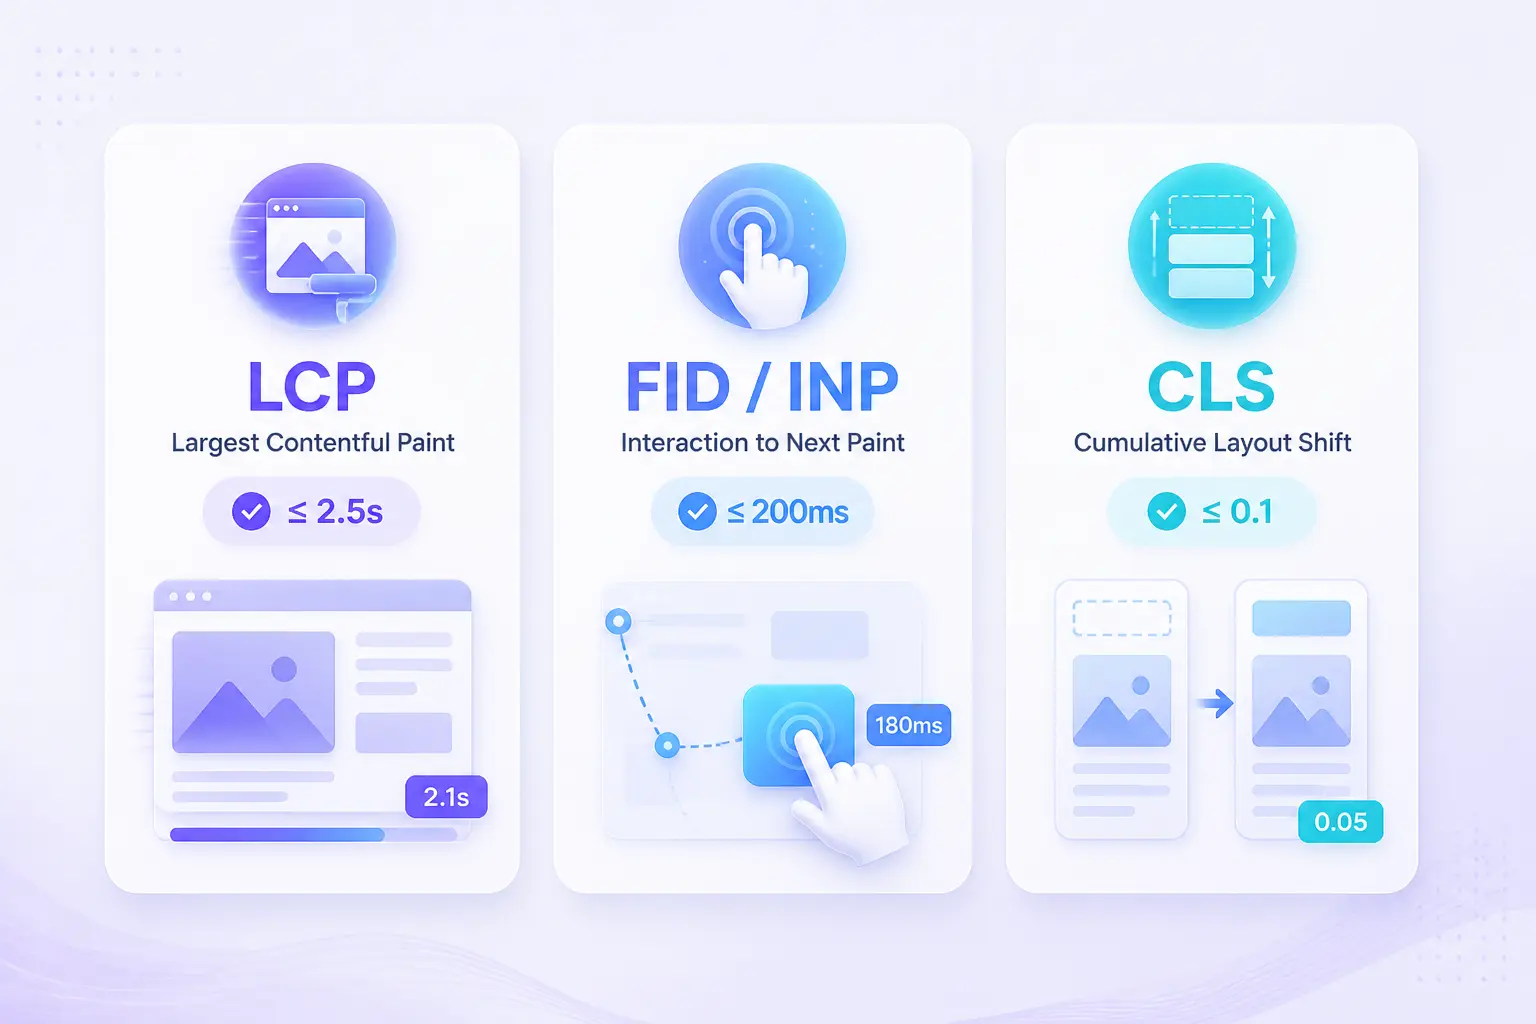
Core Web Vitals đo trải nghiệm tải trang thực tế qua ba khía cạnh:
| Chỉ số | Đo lường | Ngưỡng tốt |
|---|---|---|
| LCP | Thời gian hiển thị nội dung chính | ≤ 2,5 giây |
| INP | Độ trễ phản hồi sau tương tác | ≤ 200 mili giây |
| CLS | Mức dịch chuyển bố cục ngoài ý muốn | ≤ 0,1 |
Đây là tín hiệu Page Experience. PageSpeed Insights dùng dữ liệu thực từ CrUX, còn Chrome DevTools cung cấp dữ liệu phòng thử nghiệm để chẩn đoán. Khi tối ưu, hãy tập trung vào critical rendering path: bỏ script chặn render, preload tài nguyên LCP và khai báo trước kích thước ảnh. Một ảnh thiếu width và height sẽ đẩy nội dung khi tải xong, làm CLS tăng. Đọc thêm hướng dẫn Core Web Vitals để xử lý từng chỉ số theo đúng nguyên nhân.
Quy trình Audit Technical SEO chuyên nghiệp: Bắt đầu từ đâu?

Audit technical SEO là chu kỳ kiểm tra có hệ thống, không phải việc làm một lần. Mỗi lần thêm plugin, sửa template hoặc chuyển máy chủ đều có thể tạo lỗi mới.
- Mô phỏng crawl bằng Screaming Frog hoặc Ahrefs để lập bản đồ URL, status, directives và internal links.
- Phân tích Index Coverage trong GSC để tìm trang bị chặn hoặc chưa index.
- Kiểm tra performance trên mobile và desktop, gồm Core Web Vitals cùng TTFB.
- Xác thực structured data với nội dung hiển thị.
- Phân tích log máy chủ để biết Googlebot crawl trang nào, tần suất và lỗi gặp phải.
Ưu tiên crawlability và indexability trước, performance sau, rồi mới đến enhancement. Với website trên 10.000 URL, log file analysis đặc biệt quan trọng vì phản ánh hành vi bot thật mà crawler mô phỏng không thể thay thế. Audit định kỳ giúp phát hiện sớm lỗi sau mỗi thay đổi.
Các bước tối ưu Technical SEO hiệu quả nhanh chóng
Không phải lỗi nào cũng cần dự án lớn. Hãy bắt đầu bằng tác vụ tác động cao: xác minh index, thu hồi liên kết, thêm internal links và schema, sửa 404, rút gọn redirect. Chúng bảo vệ traffic hiện có và tạo nền cho thay đổi sâu hơn.
Kiểm tra indexing
Kiểm tra indexing cho biết URL nào được Google ghi nhận hoặc bị bỏ sót. Trong GSC, Index Coverage chia URL thành Valid, Warning, Error và Excluded; không phải mọi mục Excluded đều là lỗi.
- Ưu tiên “Submitted URL not indexed”, “Crawled – not indexed” và “Redirect error”.
- Kiểm tra robots, noindex, canonical và status của từng mẫu URL.
- Dùng toán tử
site:để ước lượng nhanh quy mô index, không xem đó là con số tuyệt đối. - Sau khi sửa, yêu cầu xác thực và chờ lần crawl tiếp theo.
Mục tiêu là index đúng trang có giá trị, không phải mọi URL.
Thu hồi lost links
Backlink trỏ tới URL 404 là nguồn PageRank bị lãng phí. Giá trị đã được tạo nhưng không còn truyền tới nội dung hoạt động; có thể phục hồi mà không cần backlink mới.
Trong Ahrefs, mở Best by Links, lọc URL 404 và xem referring domains. Ưu tiên backlink từ domain có DR cao, rồi redirect 301 tới trang gần nhất về chủ đề. Không chuyển mọi lỗi về homepage vì đích không liên quan có thể thành soft 404. Cuối cùng, xác nhận redirect không qua chuỗi trung gian.
Thêm internal links
Internal link mở đường crawl, truyền PageRank và thiết lập quan hệ chủ đề. Thêm link vào nội dung cũ ít rủi ro vì không đổi URL hay cấu trúc.
- Chọn nguồn authority cao như homepage, category mạnh hoặc bài nhiều backlink.
- Trỏ tới trang cần hỗ trợ bằng anchor text mô tả đúng nội dung đích.
- Ưu tiên link tự nhiên trong đoạn; link ngữ cảnh hữu ích hơn sidebar hoặc footer.
- Tránh dồn quá nhiều link vào một đoạn.
Bảo đảm link crawlable và trang đích không redirect, noindex hoặc canonical sang URL khác.
Thêm Schema Markup
Schema là quick win khi trang có nội dung rõ nhưng thiếu nhãn máy đọc. Ưu tiên FAQPage, Product, Review, Article và BreadcrumbList theo đúng loại trang để hỗ trợ rich results.
- Xác định thực thể chính và thông tin hiển thị.
- Viết JSON-LD với loại cụ thể nhất.
- Kiểm tra bằng Rich Results Test.
- Deploy rồi theo dõi Search Appearance trong GSC sau 2–4 tuần.
Schema không bảo đảm rich result; dữ liệu sai hoặc đánh dấu nội dung ẩn có thể khiến trang mất điều kiện.
Khắc phục các trang lỗi 404
404 xuất hiện khi URL bị xóa hoặc đổi mà không chuyển hướng. Xử lý theo giá trị từng URL:
- URL có backlink: redirect 301 tới trang tương đương.
- URL bị xóa nhưng còn internal link: cập nhật trực tiếp liên kết nguồn.
- URL vô giá trị, không có thay thế: giữ 404 hoặc 410.
Tránh soft 404: máy chủ trả 200 nhưng trang báo “không tìm thấy”. Google có thể index trang rỗng. Sau khi sửa, crawl lại để bảo đảm không còn internal link hỏng hay redirect chain.
Chuyển hướng 301 và Redirect Chains
Redirect 301 báo tài nguyên đã chuyển vĩnh viễn. Nhiều bước nối tiếp tạo redirect chain, khiến bot gửi thêm request. Với A → B → C, hãy đổi thành A → C và B → C.
- Rút gọn chain từ ba hop trở lên thành chuyển hướng trực tiếp.
- Cập nhật internal links để trỏ thẳng đến URL cuối, không dựa vào redirect.
- Chuẩn hóa HTTP/HTTPS, www/non-www và trailing slash về một phiên bản.
- Dùng Screaming Frog hoặc Ahrefs tìm chain trên URL có pageview cao.
Mỗi bước trung gian tiêu tốn crawl budget và có thể giảm hiệu quả truyền link equity. Chuẩn hóa URL từ đầu giúp tránh sửa từng chuỗi khi website lớn.
Áp dụng phân trang để tối ưu khả năng thu thập dữ liệu
Phân trang chia danh sách dài thành URL theo trình tự để bot tiếp cận toàn bộ nội dung. /page/2, /page/3 nên canonical về chính mình, không về trang đầu; nếu không, Google có thể bỏ qua nội dung ở trang sau.
- Tạo link crawlable giữa trang trước, trang sau và trang số.
- Giữ URL ổn định, trả 200, tránh chuỗi vô hạn.
- Không đưa mọi biến thể bộ lọc vào chỉ mục nếu chúng không có nhu cầu tìm kiếm riêng.
- Kiểm soát faceted navigation bằng canonical, robots.txt hoặc JavaScript rendering.
Mục tiêu là cho bot đường hữu hạn đến nội dung thật mà không sinh hàng nghìn URL tham số trùng nhau.
Cách trình bày và báo cáo Technical SEO
Tìm lỗi mới là nửa đầu công việc. Nửa còn lại là biến phát hiện thành quyết định để khách hàng và developer hành động. Báo cáo phải trả lời: vấn đề ở đâu, tác động gì, sửa thế nào, ai chịu trách nhiệm và khi nào hoàn tất.
Cách trình bày vấn đề kỹ thuật với khách hàng
Khách hàng cần hiểu lỗi ảnh hưởng traffic hoặc doanh thu ra sao. Mỗi phát hiện nên theo cấu trúc:
- Vấn đề: mô tả ngắn, số URL và mẫu trang bị ảnh hưởng.
- Tác động: liên hệ tới crawl, index, thứ hạng hoặc chuyển đổi.
- Giải pháp: thay đổi cụ thể, đội thực hiện và rủi ro.
- Thời gian: công sức dự kiến và mốc kiểm tra.
Thay vì “robots.txt block đường dẫn Z”, hãy nói “X trang sản phẩm bị chặn crawl, có thể mất Y lượt truy cập mỗi tháng”. Ngôn ngữ tác động làm lý do ưu tiên rõ và giúp phân bổ nguồn lực đúng chỗ.
Các vấn đề site health nên có trong báo cáo
Báo cáo site health cần gồm các lớp chính:
- Indexing và tỷ lệ URL submitted/indexed.
- Crawl errors, broken links, crawl traps.
- Redirect issues và chuẩn hóa URL.
- Core Web Vitals trên mobile.
- Mobile usability.
- Structured data errors.
- HTTPS và mixed content.
Mỗi nhóm cần số URL bị ảnh hưởng, xu hướng tháng và mức Critical, High, Medium hoặc Low. Tách lỗi theo template và nguyên nhân để developer sửa quy tắc gốc thay vì từng URL. Báo cáo nhờ vậy trở thành bản điều hành. Cần đính kèm URL mẫu và ảnh chụp để đội thực hiện hiểu biểu hiện của nhóm lỗi.
Tác động hiện tại và kỳ vọng
Mỗi vấn đề cần ước tính tác động để ưu tiên theo quy mô. Công thức là: số URL bị ảnh hưởng × traffic trung bình của loại URL × CTR SERP hiện tại. Đây là khoảng tham chiếu, không phải cam kết.
Ví dụ, 50 category page bị noindex sai × 200 click mỗi tháng tương đương khoảng 10.000 click bị mất. Sau khi sửa, nêu thời gian crawl lại và khả năng index. Ghi rõ giả định để phân biệt dữ liệu với ước tính.
Bước tiếp theo: Ưu tiên và tiến độ xử lý
Sau phần phát hiện, chuyển báo cáo thành kế hoạch:
- Xếp task theo tác động và khẩn cấp.
- Giao rõ owner: SEO, developer hoặc content team.
- Ước tính công sức, deadline và phụ thuộc.
- Đặt tiêu chí hoàn thành: status đúng hoặc URL index lại.
- Lên ngày crawl kiểm tra sau triển khai.
Dùng task tracker chung như Notion, Jira hoặc Google Sheet thay vì email. Một nguồn duy nhất giữ bối cảnh, lịch sử và trạng thái xác minh.
Ưu tiên theo mục tiêu và loại website
Thứ tự sửa thay đổi theo website. E-commerce có nhiều URL biến thể; blog tích lũy nội dung mỏng; SaaS dựa mạnh vào JavaScript. Không nên dùng cùng trọng số cho mọi dự án.
| Loại website | Ưu tiên 1 | Ưu tiên 2 | Ưu tiên 3 |
|---|---|---|---|
| E-commerce | Crawl budget | Faceted navigation | Schema Product |
| Blog | Canonical | Thin content | Internal linking |
| SaaS | JavaScript rendering | Structured data | Core Web Vitals |
Local business thường ưu tiên trang địa điểm, tính nhất quán và mobile. Bảng chỉ là điểm khởi đầu; quyết định phải dựa trên mục tiêu, quy mô URL và audit. Lỗi nhỏ trên template toàn site có thể quan trọng hơn lỗi nặng ở một trang không traffic.
Ma trận ưu tiên công việc
Ma trận Impact/Effort biến lỗi thành thứ tự hành động:
| Công sức thấp | Công sức cao | |
|---|---|---|
| Tác động cao | Quick Wins: redirect 404, sửa broken links, thêm schema | Major Projects: tái cấu trúc, cải thiện rendering |
| Tác động thấp | Fill-ins: sửa cảnh báo nhỏ | Avoid: tốn kém, ít ảnh hưởng |
Làm Quick Wins trước để thu hồi giá trị và tạo kết quả sớm. Major Projects cần phạm vi, nguồn lực và tiêu chí rõ. Chỉ xem lại nhóm Avoid khi mục tiêu thay đổi.
Giáo dục khách hàng là một phần của Technical SEO
Lỗi tái phát khi đội ngũ không hiểu hậu quả của thay đổi nhỏ. Content team có thể gắn noindex sai; developer đổi URL không redirect; bản deploy tạo chain mới. Audit sẽ thành chữa cháy nếu không sửa nguyên nhân vận hành.
Hãy viết hướng dẫn 1–2 trang: không tự thêm noindex, không đổi URL thiếu redirect, không tạo chain và phải kiểm tra robots. Kèm checklist trước deploy cho SEO, content và developer. Tài liệu nhỏ này tạo ngôn ngữ chung, giảm lỗi lặp và chi phí audit.
Công cụ Technical SEO cần biết
Không cần bộ công cụ lớn. Năm lựa chọn dưới đây bao phủ dữ liệu Google, mobile, trình duyệt, tín hiệu URL và tốc độ. Giá trị nằm ở việc dùng đúng nguồn cho đúng câu hỏi rồi xác minh sau khi sửa.
Google Search Console
Google Search Console là dữ liệu miễn phí trực tiếp từ Googlebot, cho biết Google nhìn website ra sao. Đây là điểm đầu của mọi quy trình technical SEO.
- Index Coverage: URL hợp lệ, lỗi và bị loại.
- Core Web Vitals: trải nghiệm theo nhóm URL.
- Mobile Usability: lỗi trên mobile.
- Rich Results: schema và lỗi.
- Crawl Stats: tần suất cùng phản hồi crawl.
- Manual Actions: hình phạt thủ công.
Mỗi tuần, kiểm tra Index Coverage errors, clicks/impressions, Core Web Vitals và Crawl Stats. Theo dõi xu hướng thay vì một dao động đơn lẻ.
Google’s Mobile-Friendly Test
Google’s Mobile-Friendly Test kiểm tra một URL theo cách Google đánh giá mobile. Công cụ cho biết trang có render được không, hiển thị ảnh chụp và liệt kê lỗi như chữ nhỏ hoặc nút quá gần.
Dùng nó để chẩn đoán trang mẫu sau khi sửa template. Với lỗi hàng loạt, dùng Mobile Usability trong GSC để tìm quy mô thay vì kiểm tra từng URL.
Chrome DevTools
Chrome DevTools cung cấp dữ liệu trình duyệt để tìm nguyên nhân phía sau điểm số tổng hợp.
- Lighthouse: đo performance và CWV trong lab.
- Network: xem request và tài nguyên chặn render.
- Security: phát hiện chứng chỉ, kết nối và mixed content.
- Performance: theo dõi critical rendering path và điểm nghẽn.
DevTools giúp xác minh script nào làm INP tăng hoặc ảnh nào là LCP. Sau khi sửa trên staging, chạy lại cùng điều kiện trước deploy, rồi dùng dữ liệu thực để theo dõi dài hạn.
Ahrefs Toolbar
Ahrefs Toolbar đưa tín hiệu SEO của URL vào trình duyệt. Người kiểm tra xem được HTTP status, canonical, meta robots, indexability, noindex/nofollow và DR mà không mở công cụ khác.
Toolbar dùng để xác minh phát hiện sau crawl hoặc kiểm tra trang live. Kết hợp với Ahrefs Site Audit: crawler tìm lỗi hàng loạt, toolbar quan sát từng trường hợp và xác nhận bản sửa trong HTML, header cùng URL cuối.
PageSpeed Insights
PageSpeed Insights kết hợp hai góc nhìn về tốc độ:
- Field data từ CrUX: trải nghiệm người dùng thật.
- Lab data từ Lighthouse: kiểm tra có kiểm soát để chẩn đoán.
- Opportunities: can thiệp rút ngắn thời gian tải.
- Diagnostics: chi tiết JavaScript, ảnh và tài nguyên mạng.
Đừng chỉ nhìn điểm Performance. Đối chiếu LCP, INP, CLS ở field và lab data rồi sửa nguyên nhân tác động lớn nhất. Field data xác nhận vấn đề; lab data tìm chỗ sửa. Sau triển khai, chờ CrUX cập nhật để đánh giá.
Technical SEO cho AI search
AI search không loại bỏ hạ tầng mà mở thêm lớp tiêu thụ nội dung. Website cần dễ crawl, đồng thời cung cấp HTML và tín hiệu thực thể rõ cho mô hình. AI bot, URL tạo sai, nội dung hàng loạt và code do AI sinh vì thế trở thành vấn đề technical SEO.
Làm cho website tiếp cận được với LLMs
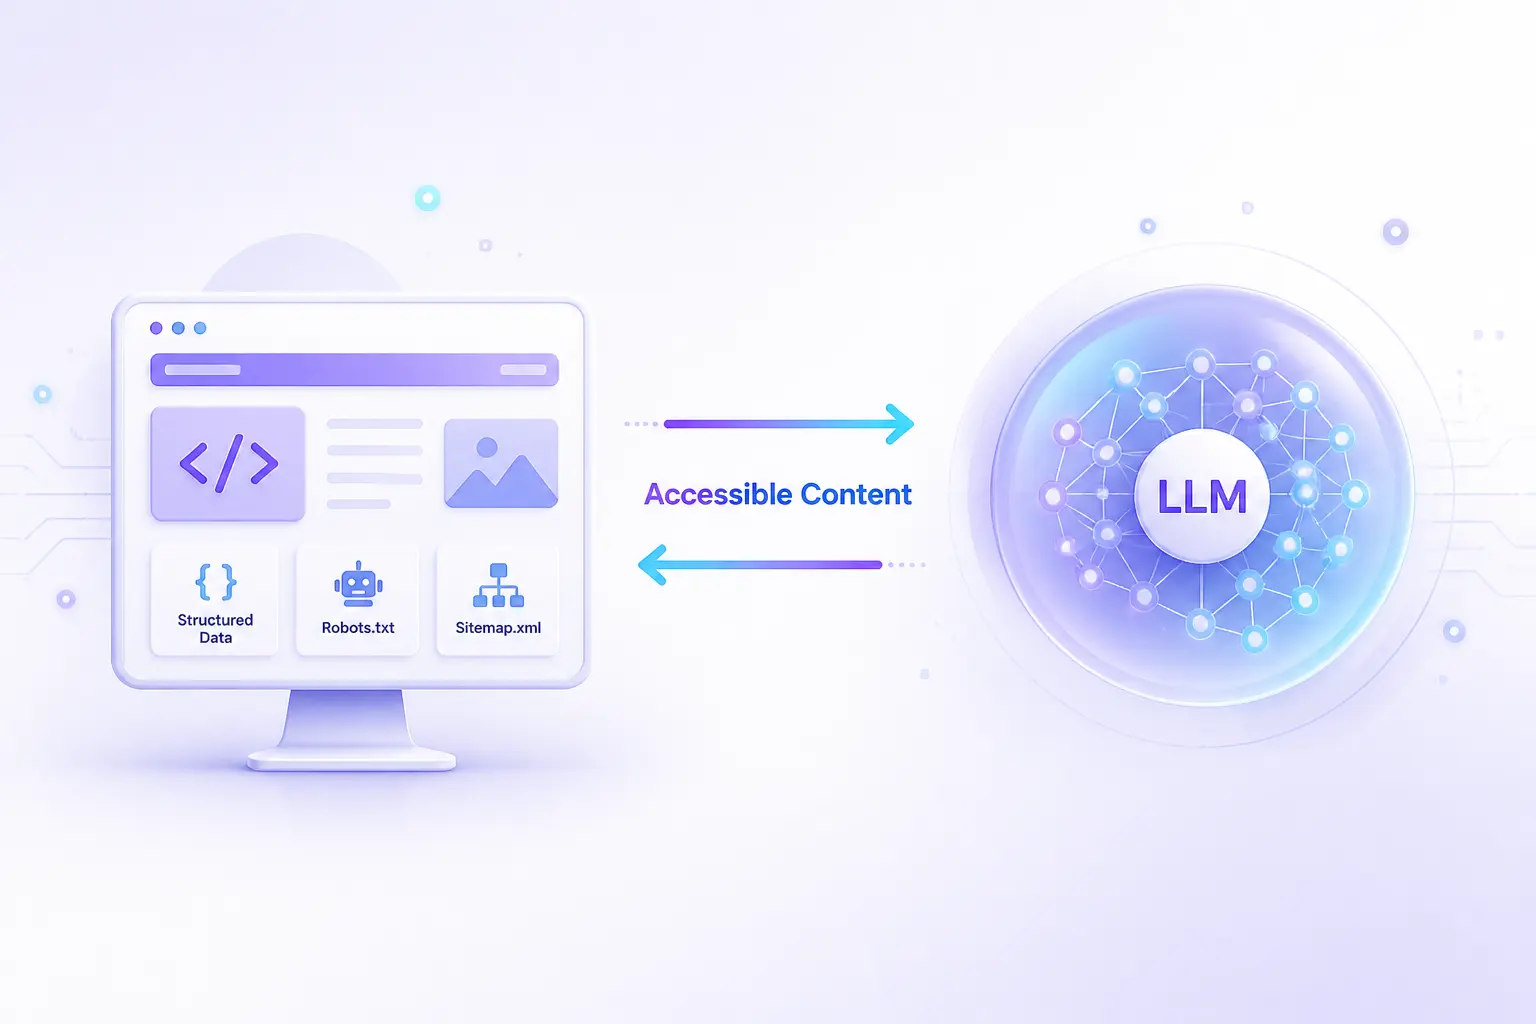
LLM tiếp cận nội dung qua crawler, nên website cần đường đọc rõ:
- Đưa nội dung chính vào HTML, không phụ thuộc hoàn toàn vào JavaScript.
- Kiểm tra robots.txt và không chặn GPTBot, ClaudeBot hoặc PerplexityBot nếu muốn các hệ thống đó đọc website.
- Cân nhắc
llms.txtđể cung cấp tóm tắt và đường dẫn ưu tiên. Đây là quy ước mới, chưa phải chuẩn chính thức. - Dùng structured data mô tả thực thể và facts nhất quán.
Thiếu schema buộc mô hình suy luận thực thể từ câu chữ, làm độ chính xác giảm. Tín hiệu rõ không bảo đảm được trích dẫn nhưng giúp nguồn bớt mơ hồ.
Redirect hallucinated URLs
Mô hình đôi khi tạo URL nghe hợp lý nhưng không tồn tại. Người dùng nhấp vào sẽ gặp 404 dù website có nội dung liên quan.
Theo dõi GSC Coverage và log máy chủ, lọc request 404 từ ChatGPT.com, Perplexity.ai hoặc Claude.ai. Nhóm đường dẫn để phân biệt URL hallucinated với request rác. Nếu có trang tương đương, redirect 301 trực tiếp; không chuyển hàng loạt về homepage. Giám sát định kỳ vừa thu hồi traffic, vừa cho biết AI diễn giải cấu trúc website ra sao.
AI content detection
Google không phạt nội dung chỉ vì do AI tạo, nhưng vẫn đánh giá chất lượng. Rủi ro xuất hiện khi hàng nghìn trang thiếu human review trở nên mỏng hoặc trùng lặp.
Content farm làm chỉ mục đầy trang ít giá trị. Google có thể giảm tần suất crawl toàn site, khiến trang tốt cập nhật chậm. Technical SEO cần kiểm tra mẫu URL, canonical và index; content team phải xác minh tính đúng, tính riêng và ích lợi trước xuất bản. Tốc độ tạo trang không thay thế kiểm soát chất lượng.
Code được chèn bởi AI tools
AI coding tools viết nhanh, nhưng code vẫn cần review trước production. Hãy kiểm tra:
- Canonical có trỏ đúng URL chuẩn.
- Noindex có bị thêm ngoài ý muốn.
- Redirect có tạo chain, loop hoặc sai đích.
- Structured data có hợp lệ và khớp nội dung.
Đưa technical SEO vào checklist: crawl staging bằng Screaming Frog, validate schema và kiểm tra robots.txt sau deploy. AI tăng tốc viết code nhưng không biết đủ quy ước URL, mục tiêu index và lịch sử migration nếu chưa được cung cấp rồi xác minh.