

Trước khi công cụ tìm kiếm đọc nội dung, nó cần biết mình được phép đi đến đâu. Robots.txt là tệp văn bản đặt tại root domain, hướng dẫn crawler phần nào của website được phép hoặc bị cấm thu thập dữ liệu. Cấu hình đúng giúp bot tập trung vào trang có giá trị thay vì khu vực quản trị, giỏ hàng hay URL lặp lại. Tuy nhiên, robots.txt chỉ kiểm soát crawl. Nó không phải công cụ bảo mật và không thay thế thẻ noindex. Bài viết này trình bày cách tạo, cấu hình, kiểm tra, sửa lỗi và tối ưu robots.txt để hỗ trợ SEO mà không vô tình đóng cửa website với công cụ tìm kiếm.
Robots.txt là gì?
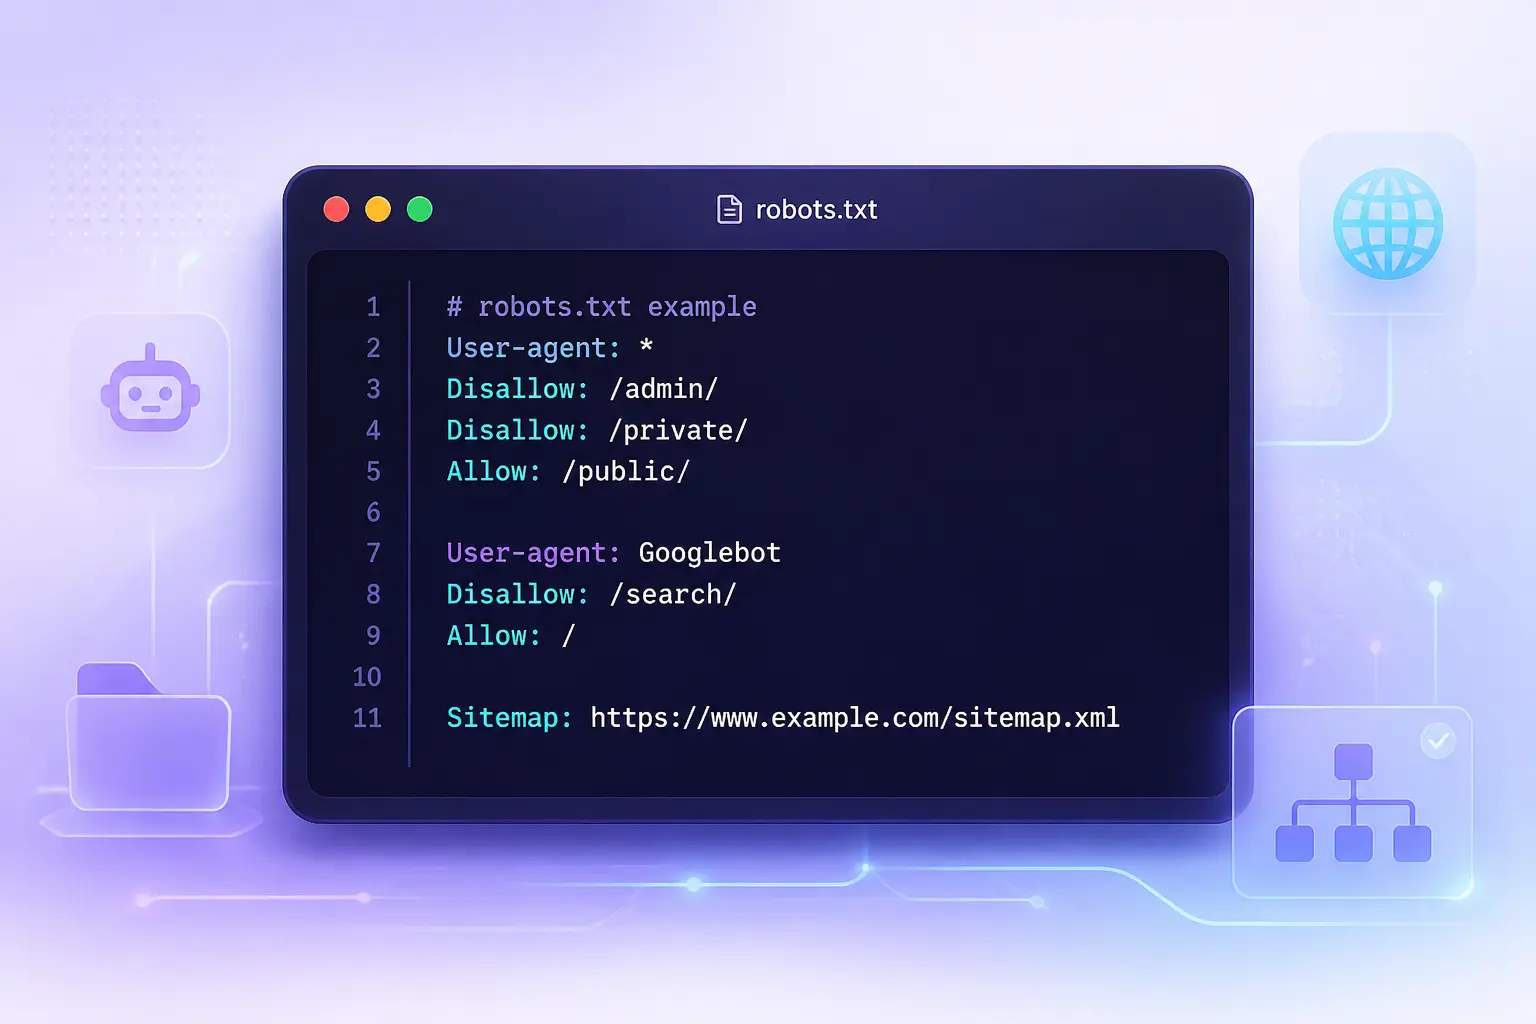
Robots.txt là tệp văn bản thuần túy đặt trong thư mục gốc của website, truy cập tại example.com/robots.txt. Theo Robots Exclusion Protocol, các directive trong tệp cho bot biết đường dẫn nào được hoặc không được crawl.
Định nghĩa ngắn: Robots.txt là biển chỉ đường cho crawler. Nó điều phối crawl nhưng không quyết định URL có xuất hiện trên kết quả tìm kiếm hay không.
Crawl là lúc bot truy cập trang; index là lúc công cụ tìm kiếm lưu và có thể hiển thị trang. Muốn ngăn một trang xuất hiện trên kết quả, cần dùng meta robots noindex hoặc X-Robots-Tag trong HTTP header.
| Phương thức | Kiểm soát crawl | Kiểm soát index |
|---|---|---|
| Robots.txt | Có | Không bảo đảm noindex |
Meta robots noindex |
Không; bot cần đọc thẻ | Có |
| X-Robots-Tag | Không nhất thiết | Có, qua HTTP header |
Robots.txt ảnh hưởng đến SEO như thế nào?
Robots.txt không trực tiếp tăng thứ hạng. Nó tác động ở bước sớm hơn: nếu crawler không đến được trang hoặc tài nguyên cần thiết, công cụ tìm kiếm sẽ thiếu dữ liệu để hiểu website.
- Tối ưu crawl budget: Crawl budget là số lần Googlebot crawl website trong một khoảng thời gian. Chặn URL không có giá trị SEO giúp bot tập trung vào nội dung, danh mục hoặc sản phẩm quan trọng. Đây là một phần trong cách công cụ tìm kiếm hoạt động.
- Giảm lãng phí tài nguyên: Trang quản trị, giỏ hàng, thanh toán hoặc URL tham số có thể tiêu tốn lượt crawl mà không thêm giá trị tìm kiếm.
- Bảo toàn khả năng render: Googlebot cần CSS, JavaScript và API endpoint để dựng trang. Nếu bị chặn, Google có thể hiểu sai bố cục, nội dung và mức độ thân thiện trên thiết bị di động; việc đánh giá Core Web Vitals cũng có thể bị ảnh hưởng.
Cấu trúc tệp robots.txt gồm những gì?
Một tệp robots.txt hợp lệ được chia thành các nhóm directive. Mỗi nhóm mở đầu bằng User-agent, sau đó là các lệnh như Disallow, Allow hoặc Crawl-delay. Mỗi directive nằm trên một dòng riêng; dòng bắt đầu bằng # là chú thích và không tạo quy tắc. Tệp nên được lưu dưới dạng văn bản thuần với encoding UTF-8 để bot đọc ổn định.
Trình tự cơ bản gồm bốn lớp:
- Chọn crawler bằng
User-agent. - Đóng một khu vực bằng
Disallow. - Mở ngoại lệ cần thiết bằng
Allow. - Khai báo sitemap để chỉ vị trí danh sách URL quan trọng.
# Quy tắc dành cho Googlebot
User-agent: Googlebot
Disallow: /private/
Allow: /private/public-page/

# Quy tắc chung
User-agent: *
Disallow: /admin/

Sitemap: https://example.com/sitemap.xml
Bot đọc tệp từ trên xuống và áp dụng nhóm User-agent phù hợp đầu tiên. Nhóm gọi đích danh bot được ưu tiên hơn wildcard *. Quy tắc trong nhóm chung phía sau không tự động bổ sung cho nhóm cụ thể đã khớp trước đó. Vì vậy, cần gom đủ rule vào đúng nhóm và tránh nhiều nhóm trùng tên.
User-agent
User-agent xác định crawler nào phải tuân theo nhóm quy tắc ngay bên dưới. Dấu * đại diện cho tất cả bot, còn tên cụ thể chỉ nhắm đến crawler tương ứng. Chẳng hạn, website có thể đặt một nhóm cho Googlebot, một nhóm cho Bingbot và một nhóm mặc định. Bot cụ thể sẽ chọn nhóm mang đúng tên của mình trước nhóm chung.
User-agent: Googlebot
Disallow: /google-private/

User-agent: Bingbot
Disallow: /bing-private/

User-agent: *
Disallow: /common-private/
Disallow
Disallow yêu cầu bot không crawl một đường dẫn hoặc thư mục. Giá trị / đóng toàn bộ website; /admin/ chỉ đóng thư mục admin. Ngược lại, Disallow: để trống cho phép nhóm bot crawl toàn site. Một dấu gạch chéo cũng có thể đổi phạm vi, nên cần kiểm tra trước khi đưa lên production.
User-agent: *
Disallow: /admin/
Muốn chặn toàn site, dùng:
User-agent: *
Disallow: /
Allow
Allow tạo ngoại lệ trong khu vực đã bị Disallow. Khi toàn site bị chặn nhưng /public/ cần mở, quy tắc này cho bot đi vào đúng nhánh đó. Nếu Allow và Disallow cùng khớp một URL, path cụ thể hơn được xem xét; khi hai path dài bằng nhau, Allow được ưu tiên.
User-agent: *
Disallow: /
Allow: /public/
Crawl-delay
Crawl-delay: 10 yêu cầu bot chờ 10 giây giữa hai request liên tiếp, qua đó giảm áp lực lên server. Bingbot và một số crawler khác hỗ trợ directive này, nhưng Google không hỗ trợ. Với Googlebot, việc điều chỉnh crawl rate cần thực hiện qua Google Search Console thay vì dựa vào dòng Crawl-delay trong robots.txt.
Sitemap
Directive Sitemap khai báo địa chỉ sitemap XML, giúp crawler tìm nội dung quan trọng nhanh hơn. Đây là thực hành nên có và thường đặt ở cuối robots.txt. Một file có thể chứa nhiều dòng Sitemap. Địa chỉ phải là URL tuyệt đối, gồm giao thức và domain.
Sitemap: https://example.com/sitemap.xml
Sitemap: https://example.com/sitemap-products.xml
Xem cách tổ chức XML sitemap để hai tệp cùng dẫn crawler đến đúng nội dung.
Robots.txt hoạt động như thế nào?
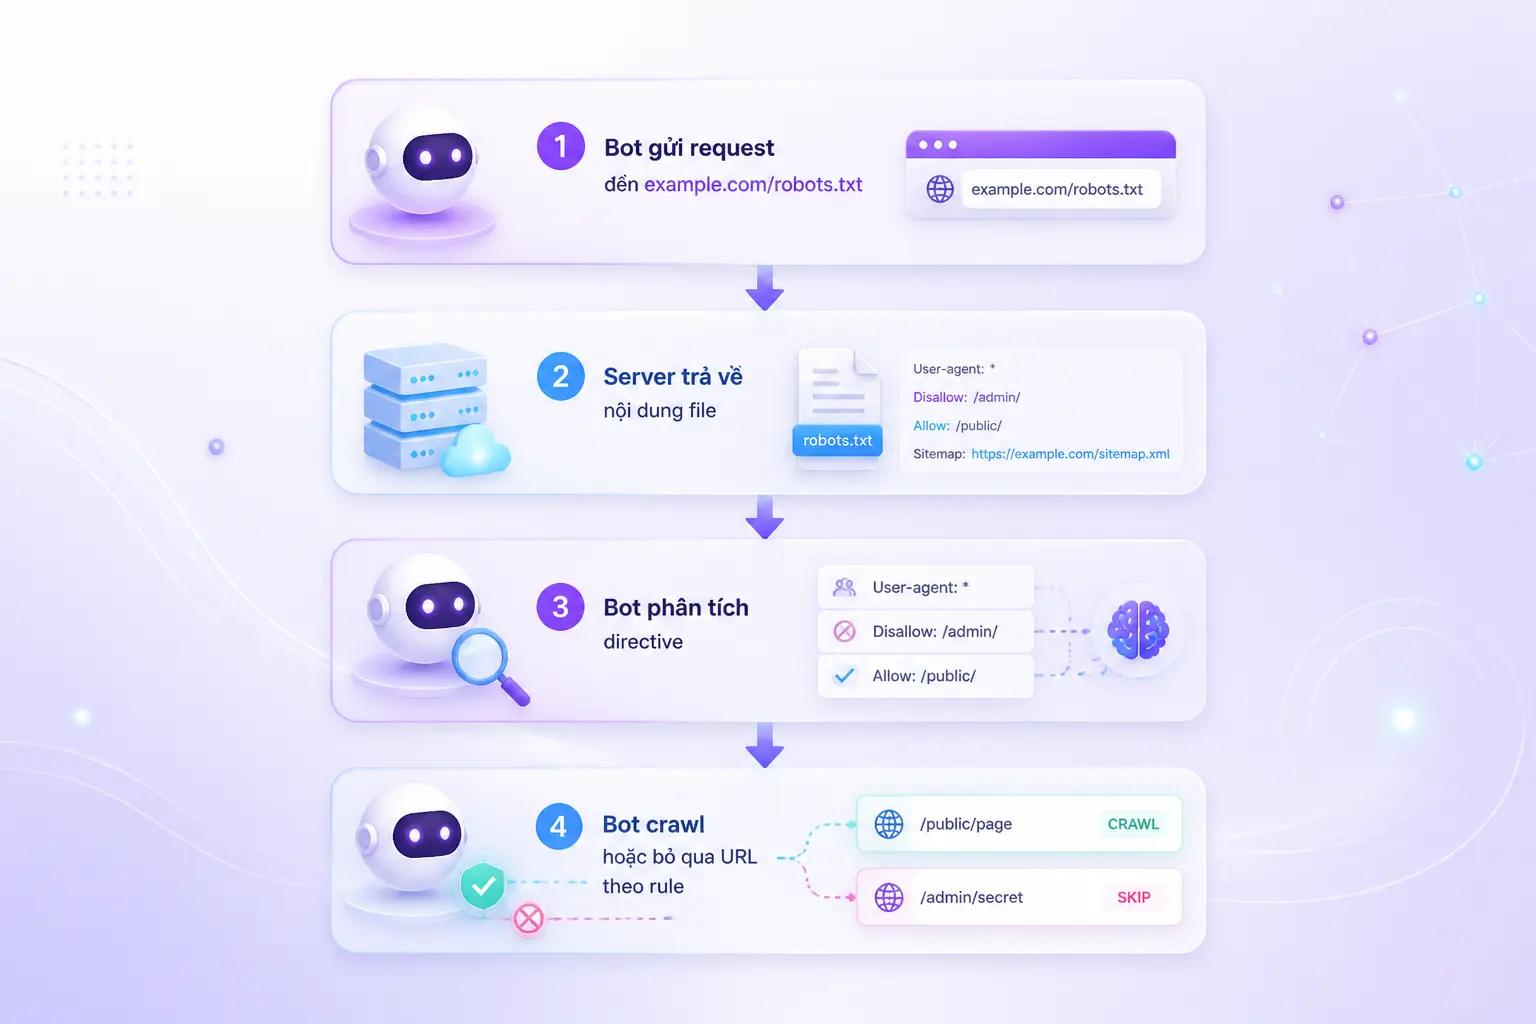
Crawler kiểm tra robots.txt trước các URL khác trên cùng host. Bot tìm tệp hướng dẫn, chọn nhóm dành cho mình, đối chiếu đường dẫn rồi mới quyết định gửi request.
- Fetch tệp: Bot yêu cầu
domain.com/robots.txt. File tạidomain.com/folder/robots.txtkhông điều khiển toàn website. - Xử lý khi không có tệp: Nếu robots.txt trả về 404, bot mặc định có thể crawl toàn site.
- Chọn nhóm: Bot tìm
User-agentđúng tên; nếu không có, nó dùng wildcard*. Với nhiều nhóm, bot áp dụng nhóm phù hợp đầu tiên, nên nhóm khớp phía sau có thể bị bỏ qua. - Đối chiếu: Bot so URL với
DisallowvàAllow, sau đó crawl hoặc dừng.
Phạm vi gắn với host chứa file. Vì vậy, domain chính và mỗi subdomain cần robots.txt riêng; tệp ở domain chính không tự động kiểm soát các subdomain.
Cách tạo tệp robots.txt
- Tạo file plain text. Dùng trình soạn thảo văn bản thuần túy và lưu với encoding UTF-8.
- Đặt đúng tên. File phải là
robots.txt, viết thường; không dùngrobot.txthayrobots.TXT. - Viết directive. Đặt mỗi lệnh trên một dòng. Cấu hình mở site có thể dùng
User-agent: *,Disallow:để trống và địa chỉ sitemap. - Upload lên thư mục gốc. File phải truy cập được qua
https://yourdomain.com/robots.txt. - Kiểm tra URL. Mở địa chỉ trên và xác nhận server trả đúng nội dung.
Trên WordPress, có thể vào Yoast SEO → Tools → File Editor để tạo hoặc sửa robots.txt trong dashboard mà không cần FTP. Rank Math cũng có chức năng tương tự. Dù dùng plugin hay upload thủ công, file vẫn phải đúng tên, đúng vị trí và đúng cú pháp. Trước khi lưu, cần kiểm tra kỹ Disallow, vì một rule quá rộng có thể đóng nhầm nội dung Google cần crawl.
Tùy chỉnh robots.txt cho từng trường hợp
Không có một robots.txt phù hợp cho mọi website. Cấu hình nên bắt đầu từ hai câu hỏi: khu vực nào cần crawler đọc để phục vụ tìm kiếm, và khu vực nào chỉ phục vụ vận hành?
Các trường hợp phổ biến gồm:
- Khu vực quản trị hoặc đăng nhập: Thường không cần bot crawl.
- Quy trình giao dịch: Giỏ hàng và thanh toán có thể lãng phí crawl budget.
- Nhóm URL cùng mẫu: Wildcard bao phủ nhiều URL tham số hoặc file cùng đuôi.
- Môi trường thử nghiệm: Staging cần đóng trước khi nội dung lên production.
Cần đánh giá đường dẫn thực tế thay vì sao chép mẫu. Một URL kỹ thuật vẫn có thể cung cấp CSS, JavaScript hoặc API cần để render; chặn nhầm khiến bot thấy phiên bản thiếu. Sau mỗi thay đổi, hãy chọn đúng User-agent, đối chiếu từng path và xác nhận ngoại lệ Allow đủ cụ thể.
Chặn thư mục không có giá trị SEO
Trang admin, đăng nhập, giỏ hàng và thanh toán thường không mang nội dung cần xếp hạng. Chặn các path /wp-admin/, /login/, /cart/ và /checkout/ giúp Googlebot dành lượt crawl cho trang nội dung quan trọng. Với WordPress, vẫn nên mở admin-ajax.php vì endpoint này có thể cần cho chức năng và việc render trang. Đây là ngoại lệ cần ghi rõ bằng Allow.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /login/
Disallow: /cart/
Disallow: /checkout/
Sử dụng wildcard để gom nhóm đường dẫn
Ký tự * đại diện cho một chuỗi ký tự bất kỳ, giúp một rule áp dụng cho nhiều URL có cùng mẫu. Ký tự $ đánh dấu điểm kết thúc URL. Vì vậy, Disallow: /*? chặn các URL chứa query string, còn Disallow: /*.pdf$ chỉ khớp những URL kết thúc bằng .pdf. Wildcard rất mạnh nhưng dễ mở rộng phạm vi ngoài dự kiến, nên cần thử trên URL mẫu.
User-agent: *
Disallow: /*?
Disallow: /*.pdf$
Robots.txt cho môi trường staging
Môi trường staging nên đóng toàn bộ crawler bằng User-agent: * và Disallow: /. Cấu hình này ngăn nội dung thử nghiệm bị crawl trước khi website ra mắt, đồng thời giảm nguy cơ xuất hiện phiên bản trùng lặp. Khi migrate sang production, phải cập nhật robots.txt ngay để mở crawl. Quên gỡ Disallow: / là lỗi phổ biến khiến toàn bộ website mới không được thu thập dữ liệu.
Best practices cho robots.txt
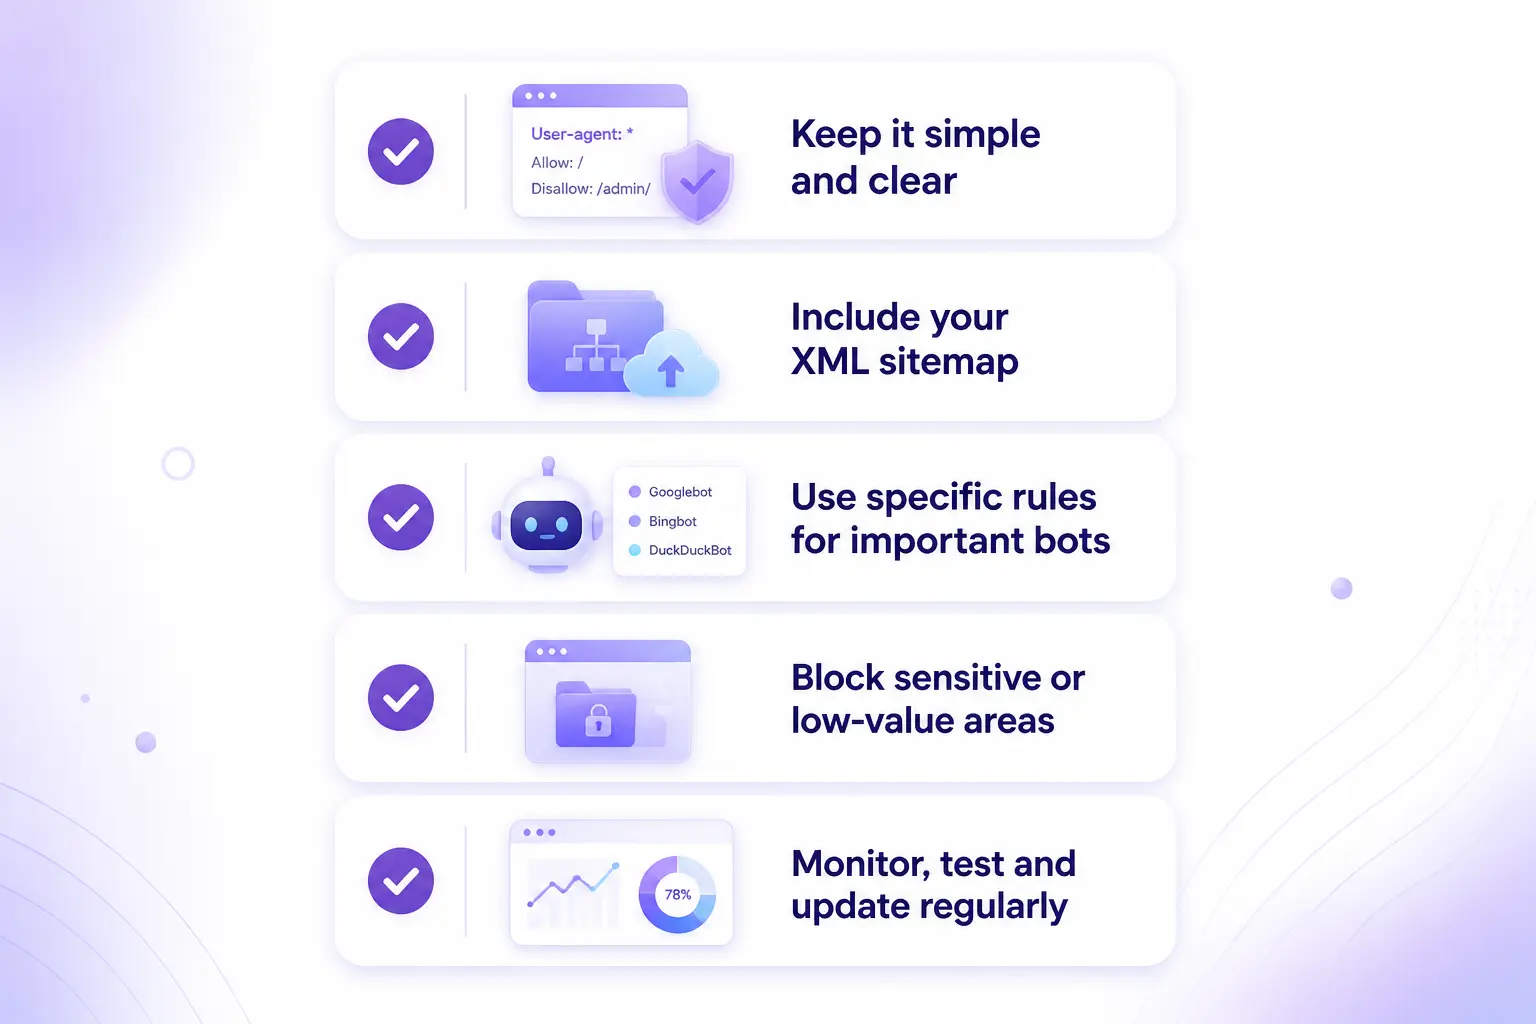
- Cho phép tài nguyên render. Không chặn CSS, JavaScript hoặc API endpoint. Googlebot cần chúng để hiểu bố cục, nội dung và trải nghiệm di động.
- Khai báo sitemap. Đặt dòng
Sitemapvới URL tuyệt đối ở cuối file để chỉ nơi bot nên khám phá. - Dùng quy tắc cụ thể. Chặn đúng thư mục hoặc mẫu URL thay vì một
Disallowquá rộng; thêmAllowkhi cần mở đường dẫn con. - Giữ file dễ đọc. Mỗi directive nằm trên một dòng, file lưu UTF-8 và chú thích bắt đầu bằng
#. - Kiểm tra trước và sau khi publish. Dùng Robots Testing Tool trong Google Search Console để kiểm tra cú pháp, rồi dùng URL Inspection Tool xác nhận URL quan trọng không bị chặn.
Robots.txt nên được rà soát trong technical SEO, không phải thiết lập một lần rồi bỏ quên. Đổi cấu trúc URL, thêm subdomain, chuyển staging sang production hoặc triển khai chức năng mới đều có thể làm rule cũ sai phạm vi. Kiểm tra định kỳ giúp chỉ dẫn crawl bám đúng kiến trúc website.
Phát hiện và sửa lỗi robots.txt
Lỗi robots.txt thường nằm ở khoảng cách giữa điều người quản trị định chặn và điều crawler hiểu. Quy trình cập nhật cho Search Console năm 2026 gồm:
- Lập danh sách: Dùng Screaming Frog, Sitebulb và báo cáo Page indexing để tìm URL “Blocked by robots.txt” hoặc “Indexed, though blocked by robots.txt”.
- Xếp mức độ: Ưu tiên homepage, danh mục, sản phẩm và tài nguyên render thiết yếu.
- Xác nhận: Dùng URL Inspection live test và robots.txt validator để tìm rule đang khớp.
- Sửa: Thu hẹp
Disallowhoặc thêmAllow, lưu UTF-8 rồi kiểm tra cú pháp. - Yêu cầu đọc lại: Dùng robots.txt report để request recrawl file; với URL vừa mở chặn, dùng URL Inspection khi cần.
Một URL bị chặn không luôn là lỗi: trang thanh toán có thể nên bị chặn, còn trang sản phẩm thì không. Mục tiêu không phải đưa số URL “Blocked” về không, mà bảo đảm mỗi đường dẫn bị chặn có lý do và trang cần tìm kiếm vẫn mở cho crawler.
Bước 1 — Chạy crawl kiểm tra website
Dùng Screaming Frog hoặc Sitebulb để crawl toàn site và lọc “Blocked by robots.txt”. Trong Search Console, mở báo cáo Page indexing, không còn dùng đường dẫn cũ Coverage → Excluded. Tìm các lý do liên quan đến robots.txt để biết Google đang nhìn thấy vấn đề ở quy mô nào.
Bước 2 — Kiểm tra các lỗi crawl nghiêm trọng
Ưu tiên homepage, trang danh mục, sản phẩm và file CSS/JavaScript thiết yếu. Hai trạng thái cần phân biệt là Blocked by robots.txt và Indexed, though blocked by robots.txt. Trạng thái thứ hai cho thấy URL vẫn có thể vào index dù Google không crawl nội dung.
Bước 3 — Lọc các vấn đề liên quan đến robots.txt
Chia danh sách thành trang bị chặn nhầm, URL bị chặn đúng và URL cần noindex thay vì Disallow. Với từng trường hợp, dùng URL Inspection để kiểm tra bản đã index và Test Live URL để xem khả năng truy cập hiện tại. Phân loại này tránh mở hàng loạt URL vốn nên nằm ngoài luồng crawl.
Bước 4 — Rà soát và sửa directive
Mở robots.txt, xác định user-agent cụ thể nhất và rule có path khớp dài nhất. Sửa chữ hoa/thường, thu hẹp wildcard hoặc bổ sung Allow. Lưu file UTF-8, upload lên đúng origin, rồi dùng validator và robots.txt report để kiểm tra lỗi parse. Luôn thử một URL phải mở và một URL phải chặn.
Bước 5 — Crawl lại để xác nhận sửa lỗi
Sau khi file mới có hiệu lực, crawl lại và dùng URL Inspection để xem live test, screenshot hoặc HTML đã render. Fetch & Render là công cụ cũ và không còn là quy trình năm 2026. Có thể chọn Request Indexing cho URL quan trọng; với robots.txt, dùng Request a recrawl trong robots.txt report.
Lỗi robots.txt thường gặp cần tránh
- Chặn toàn bộ production:
Disallow: /dướiUser-agent: *đóng website với crawler tuân thủ. Lỗi thường xảy ra khi giữ file staging, khiến nội dung không được crawl. - Dùng robots.txt để xử lý index: Google vẫn có thể biết URL qua backlink. Muốn tránh index bloat, cần dùng công cụ kiểm soát index phù hợp.
- Chặn tài nguyên render: Đóng theme, script hoặc API tạo nội dung có thể khiến Googlebot nhận trang thiếu.
- Sai tên hoặc định dạng:
/robots.TXTkhông thay thế/robots.txt. Encoding sai, HTML hoặc phần vượt 500 KiB có thể bị bỏ qua. - Wildcard quá rộng: Dấu
*có thể gom nhiều URL hơn dự kiến và vô tình chặn trang quan trọng. - Để robots.txt trả lỗi server:
5xx, timeout hoặc lỗi DNS có thể khiến Google tạm dừng crawl.
Giữ file đơn giản, kiểm tra trên production và rà soát sau mỗi lần đổi cấu trúc website.
Robots.txt và các phương pháp kiểm soát crawl liên quan
| Phương thức | Kiểm soát crawl | Kiểm soát index |
|---|---|---|
| Robots.txt | Chặn bot truy cập URL hoặc path | Không bảo đảm noindex |
Meta robots noindex |
Cho bot crawl để đọc thẻ | Ngăn trang vào index |
| X-Robots-Tag | Không tự chặn crawl | Kiểm soát index qua HTTP header |
Chọn theo mục tiêu: dùng robots.txt để chặn truy cập; dùng meta noindex hoặc X-Robots-Tag để ngăn index. Không chặn crawl rồi chờ bot đọc noindex, vì bot không thấy chỉ dẫn trong trang đã đóng.
X-Robots-Tag phù hợp với PDF, video, hình ảnh và tài nguyên không có HTML. Nội dung nhạy cảm cần xác thực phía server.
Robots.txt cho AI crawlers
Năm 2026, một nhà cung cấp có thể tách bot huấn luyện, tìm kiếm và truy cập do người dùng gọi. Chính sách phải dựa trên từng user-agent.
- OpenAI:
GPTBotdành cho nội dung có thể dùng huấn luyện;OAI-SearchBotphục vụ ChatGPT Search.ChatGPT-Userdo người dùng khởi tạo nên robots.txt có thể không áp dụng. - Anthropic:
ClaudeBotphục vụ huấn luyện,Claude-SearchBotphục vụ tìm kiếm,Claude-Userphục vụ yêu cầu người dùng. - Common Crawl:
CCBotthu thập kho dữ liệu web mở, kiểm tra robots.txt và hỗ trợCrawl-delay.
Chặn bot huấn luyện không ảnh hưởng trực tiếp thứ hạng Google nếu Googlebot vẫn mở. Chặn bot tìm kiếm AI có thể giảm khả năng xuất hiện trong sản phẩm tương ứng.
Ví dụ cho phép ChatGPT Search nhưng từ chối GPTBot:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Tổng kết — Robots.txt trong chiến lược Technical SEO
Robots.txt kiểm soát crawl cơ bản nhưng ảnh hưởng rộng. Cấu hình đúng giúp robots.txt SEO giảm URL không cần truy cập và giữ tài nguyên render thiết yếu mở. Cấu hình sai, nhất là chặn production hoặc dựa vào thứ tự rule, có thể đóng nội dung quan trọng. Tệp văn bản root domain cần được kiểm tra khi website đổi cấu trúc, môi trường hoặc chính sách bot AI. Nó hiệu quả nhất khi kết hợp sitemap XML, meta robots, X-Robots-Tag, mã HTTP đúng và URL hợp lý trong một hệ thống technical SEO thống nhất. Site nhỏ nên ưu tiên sự đơn giản; site lớn cần dựa trên log và Search Console.
Robots.txt có ngăn hoàn toàn việc index trang không?
Không. Robots.txt chỉ ngăn crawler truy cập nội dung, không bảo đảm URL bị loại khỏi index. Google vẫn có thể phát hiện URL qua backlink và hiển thị kết quả không có mô tả. Muốn ngăn index, cần bỏ chặn để bot đọc meta robots noindex hoặc X-Robots-Tag; với nội dung riêng tư, dùng xác thực phía server.
Robots.txt có bắt buộc cho mọi website không?
Không. Website không có robots.txt vẫn có thể được Google crawl. Với Google, 404 tại /robots.txt được hiểu là không có hạn chế; hầu hết 4xx khác cũng vậy, trừ 429. Dù không bắt buộc, file hợp lệ giúp website chủ động quản lý crawler và khai báo sitemap. Nếu không có khu vực cần chặn, robots.txt có thể rất ngắn.
Có thể dùng robots.txt để ẩn nội dung nhạy cảm không?
Không. Robots.txt là tệp công khai. URL trong Disallow vẫn truy cập được bằng trình duyệt, còn crawler không tuân thủ có thể bỏ qua chỉ dẫn. Việc liệt kê đường dẫn nhạy cảm thậm chí có thể làm lộ vị trí cần bảo vệ. Nội dung riêng tư và staging phải được khóa bằng xác thực hoặc kiểm soát truy cập phía server, không phải robots.txt.