
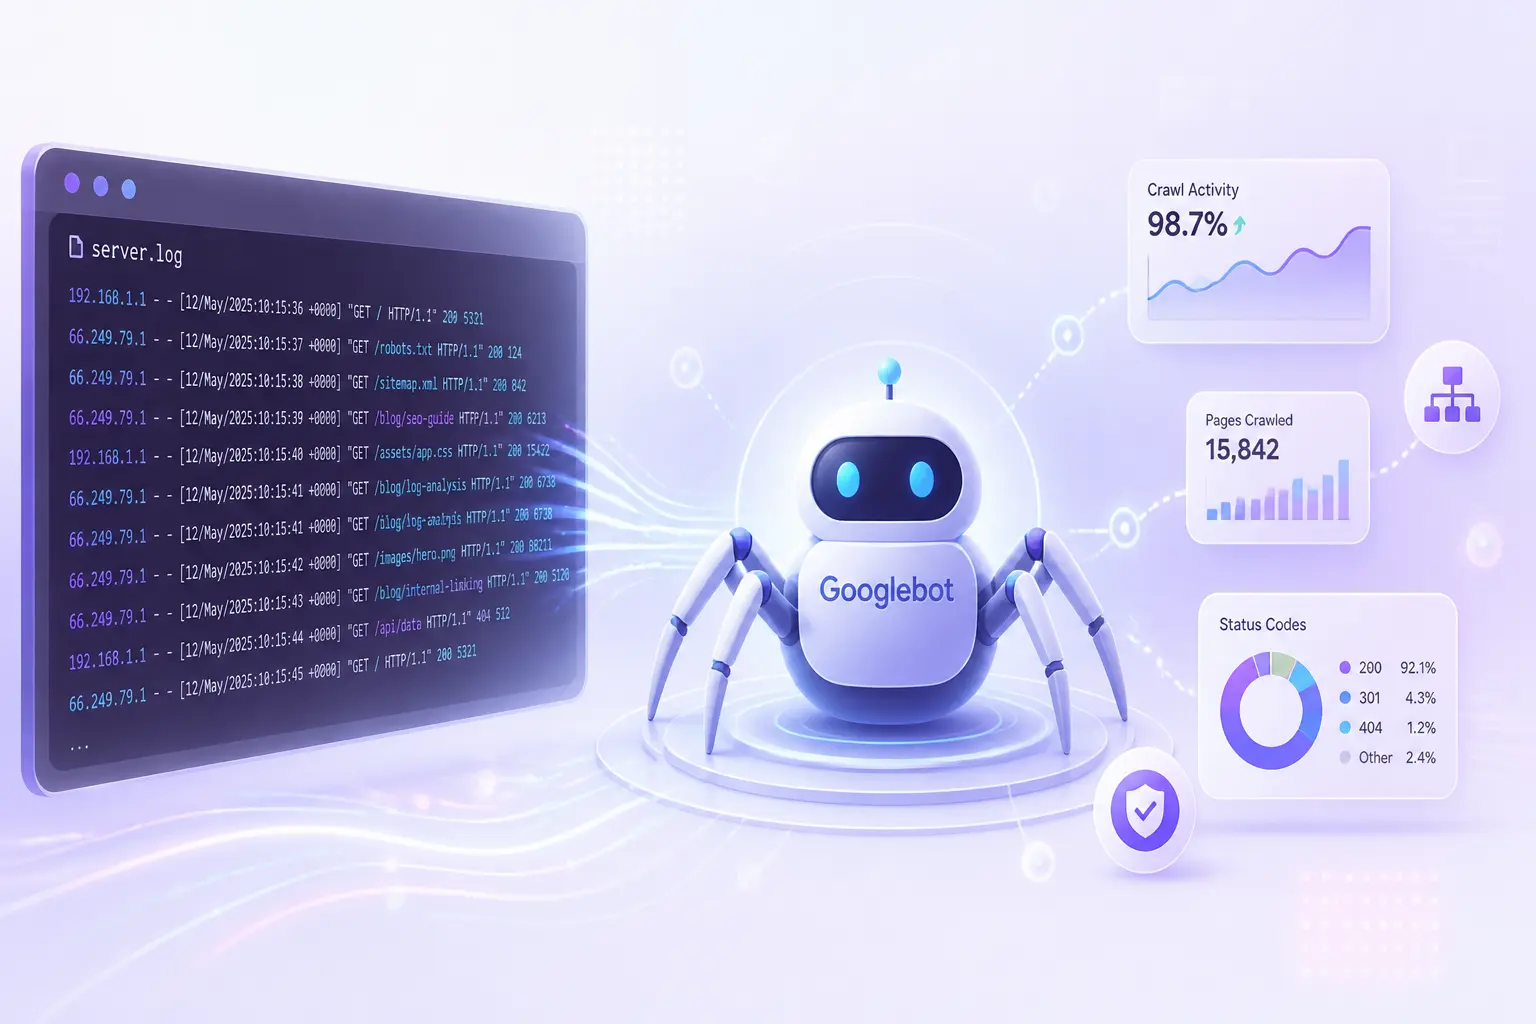
Log file analysis SEO là cách bạn đọc trực tiếp nhật ký máy chủ để biết Googlebot crawl website của bạn thực sự như thế nào, thay vì đoán mò qua các công cụ mô phỏng. Khác với một bài audit thông thường chỉ crawl thử website giống như một con bot giả lập, log file analysis cho bạn xem đúng những gì đã xảy ra giữa server của bạn và các bot tìm kiếm. Bài viết này sẽ đi theo một trình tự logic: đầu tiên là hiểu log file là gì, sau đó học cách truy xuất và phân tích chúng, rồi cuối cùng biến những con số đó thành hành động tối ưu crawl budget cụ thể.
Log File Là Gì?

Log file là bản ghi tự động, được server tạo ra cho mọi request gửi đến website của bạn. Bạn có thể hình dung nó như một cuốn sổ trực nhật của tòa nhà: mỗi khi có ai đó, dù là người dùng hay một con bot, bước vào và yêu cầu xem một trang, server sẽ ghi lại chuyện đó thành một dòng. Chuẩn ghi log phổ biến nhất theo quy ước của W3C mô tả rõ cấu trúc này. Mỗi dòng log thường chứa địa chỉ IP của người gửi request, thời gian chính xác, phương thức request (như GET hay POST), đường dẫn được yêu cầu và mã trạng thái phản hồi mà server trả về. Chỉ với vài trường dữ liệu đơn giản này, bạn đã có đủ nguyên liệu để tái dựng lại toàn bộ hành vi của bot trên website.
Log File Analysis Là Gì?

Log file analysis là quá trình đọc và diễn giải những dòng log đó để xác định các bot tìm kiếm, đặc biệt là Googlebot, đang hành xử ra sao trên website của bạn. Điều làm log file analysis khác biệt so với các hình thức SEO analysis khác nằm ở nguồn dữ liệu: một cuộc audit thông thường dùng crawler giả lập để đoán xem Googlebot có thể làm gì, còn log file analysis dùng chính dữ liệu server thực tế, tức là những gì Googlebot đã thực sự làm. Nói cách khác, crawler cho bạn biết “website này có thể được crawl như thế nào”, còn log file cho bạn biết “Googlebot đã crawl website này như thế nào”. Sự khác biệt tưởng nhỏ này lại quyết định rất nhiều trong việc chẩn đoán đúng vấn đề.
Vì Sao Log File Analysis Quan Trọng Với SEO?

Lý do log file analysis quan trọng nằm ở chỗ nó cho bạn thấy trực tiếp cách Googlebot phân bổ crawl budget, tức là lượng thời gian và tài nguyên mà Googlebot dành ra để crawl website của bạn trong một khoảng thời gian nhất định. Crawl budget được xác định bởi hai yếu tố: giới hạn tốc độ crawl mà server của bạn chịu được, và nhu cầu crawl, tức mức độ Google muốn crawl website dựa trên độ phổ biến và tần suất cập nhật nội dung. Với những website có cấu trúc URL phức tạp, một phần không nhỏ crawl budget này thường bị lãng phí vào các URL tham số không mang lại giá trị SEO. Ngoài ra, Google Search Console còn có báo cáo phân loại các trang thuộc nhóm “Discovered – currently not indexed”, tức là những trang Google đã biết đến nhưng chưa từng crawl, và đây chính là khoảng cách giữa việc được biết đến và việc thực sự được index mà log file analysis giúp bạn phát hiện ra. Cụ thể, log file analysis mang lại cho bạn:
- Biết chính xác Googlebot có đang ghé thăm những trang quan trọng nhất hay không
- Phát hiện các trang bị crawl lãng phí dù không có giá trị SEO
- Nhìn thấy khoảng cách giữa trang được crawl và trang thực sự được index
- Chẩn đoán lỗi kỹ thuật thông qua mã trạng thái mà bot gặp phải
Các Loại và Định Dạng Log File

Trước khi đi vào cách phân tích, bạn cần biết log file có thể tồn tại dưới nhiều định dạng khác nhau tùy vào loại server bạn đang dùng.
Các Định Dạng Log Server Phổ Biến
| Định dạng | Server | Trường dữ liệu | Ghi chú |
|---|---|---|---|
| Common Log Format (CLF) | Apache | IP, thời gian, request, status code, kích thước phản hồi | Định dạng cơ bản nhất, không có referrer và user-agent |
| Combined Log Format | Apache, Nginx | CLF cộng thêm referrer và user-agent | Định dạng phổ biến nhất hiện nay vì đủ dữ liệu để phân tích bot |
| W3C Extended Log Format | IIS (Windows Server) | Các trường tùy chỉnh do quản trị viên lựa chọn | Linh hoạt nhưng cần cấu hình đúng để có đủ dữ liệu SEO |
| JSON Log | Nginx, các CDN hiện đại | Toàn bộ trường ở dạng object JSON | Dễ xử lý bằng script và nạp trực tiếp vào công cụ như BigQuery |
Bốn định dạng này đều được các web server phổ biến sử dụng, và trong đó Combined bổ sung thêm referrer cùng user-agent so với Common, giúp bạn xác định được bot nào đang truy cập chứ không chỉ là có request hay không.
Hiểu Các Trường Dữ Liệu Quan Trọng Trong Log File
Mỗi dòng log chứa những trường dữ liệu sau, và bạn cần hiểu rõ từng trường trước khi bắt tay vào phân tích:
- IP address: địa chỉ nguồn gửi request, dùng để xác định danh tính bot hoặc người dùng
- Timestamp: thời điểm chính xác request được gửi đến, giúp bạn dựng lại tần suất crawl theo thời gian
- Request method: GET, POST hay các phương thức khác
- Request path: đường dẫn URL cụ thể được yêu cầu
- Status code: mã phản hồi của server, ví dụ 200, 301, 404
- User-agent: chuỗi định danh cho biết ai đang gửi request, đây là trường quan trọng nhất để xác định danh tính bot truy cập website
Cách Truy Cập và Trích Xuất Log File
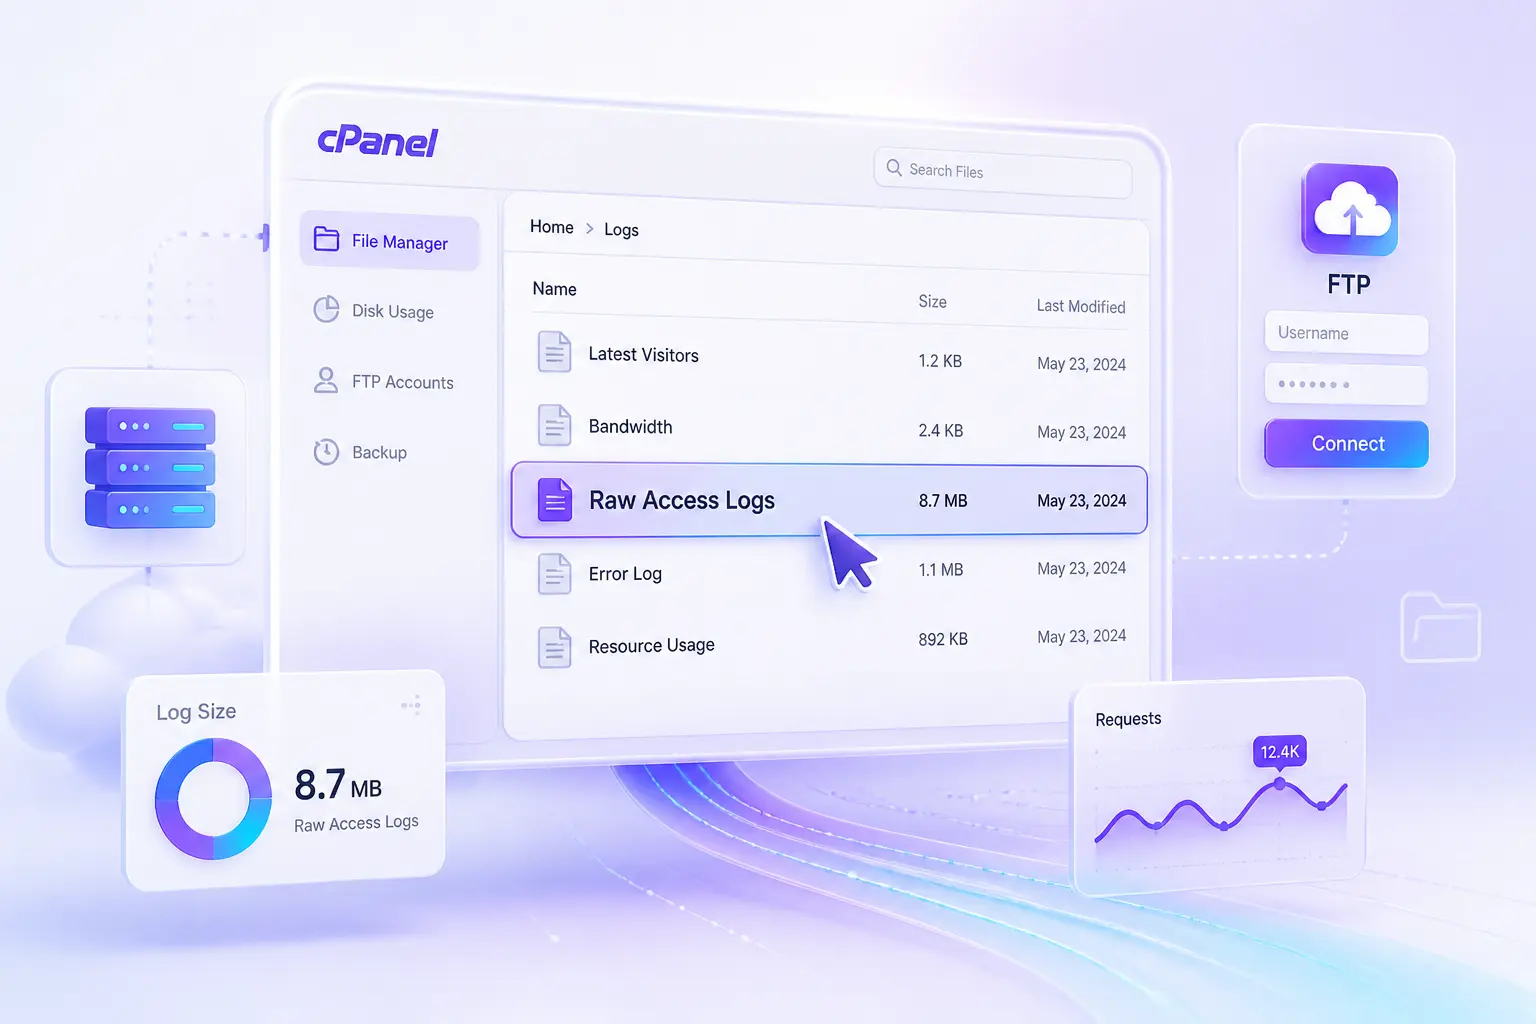
Sau khi đã hiểu cấu trúc log, bước tiếp theo là biết cách lấy được log file thực tế từ hệ thống của bạn.
Tải Log File Từ Server Của Bạn
- Đăng nhập vào bảng điều khiển hosting, thường là cPanel, sau đó tìm mục “Raw Access Logs” để tải file log về máy
- Nếu hosting không có cPanel, bạn có thể dùng FTP để kết nối trực tiếp vào thư mục logs trên server
- Với server có quyền truy cập cao hơn, dùng SSH để tải log qua dòng lệnh sẽ nhanh và linh hoạt hơn
- Nếu website đang dùng CDN như Cloudflare, bạn cần bật riêng tính năng logging của CDN, vì log gốc từ server backend sẽ không phản ánh đầy đủ request đã đi qua lớp CDN
Vấn Đề Bảo Mật và Quyền Riêng Tư Dữ Liệu
Log file chứa địa chỉ IP của người dùng, và đây là dữ liệu cần được xử lý cẩn trọng. Tại Việt Nam, Nghị định số 13/2023/NĐ-CP về bảo vệ dữ liệu cá nhân, có hiệu lực từ ngày 1 tháng 7 năm 2023, quy định chi tiết về trách nhiệm bảo vệ dữ liệu cá nhân của các tổ chức và cá nhân liên quan. Dữ liệu cá nhân theo nghị định này được định nghĩa là bất kỳ thông tin nào giúp xác định một con người cụ thể, và địa chỉ IP khi kết hợp với các dữ liệu khác trong log hoàn toàn có thể rơi vào phạm vi này.
Vì vậy, doanh nghiệp nên áp dụng nguyên tắc least privilege, tức là chỉ cấp quyền truy cập log file cho những người thực sự cần dùng đến nó, nhằm tránh rủi ro rò rỉ dữ liệu không đáng có.
Công Cụ Phân Tích Log File

Tùy vào quy mô log file của bạn, có nhiều nhóm công cụ phù hợp với độ phức tạp tăng dần, từ dòng lệnh đơn giản đến nền tảng doanh nghiệp chuyên dụng.
Công Cụ Dòng Lệnh Để Phân Tích Nhanh
- Lệnh
grepgiúp lọc nhanh các dòng log chứa từ khóa cụ thể, ví dụ user-agent của Googlebot - Lệnh
awkcho phép tách và đếm dữ liệu theo cột, ví dụ đếm số lượng status code 404 - Cách tiếp cận này phù hợp nhất khi log file của bạn có dung lượng dưới khoảng 1GB, vì xử lý bằng dòng lệnh trên log quá lớn sẽ trở nên chậm và khó kiểm soát
Phân Tích Bằng Bảng Tính
Với log file quy mô vừa, Excel hoặc Google Sheets là lựa chọn dễ tiếp cận. Bạn có thể dùng pivot table để đếm số lượng request theo từng loại user-agent, từ đó nhanh chóng biết được bot nào ghé thăm nhiều nhất.
- Phù hợp cho log vài chục nghìn đến vài trăm nghìn dòng
- Hiệu suất xử lý sẽ giảm rõ rệt khi số dòng log vượt quá vài trăm nghìn, lúc này bảng tính dễ bị treo hoặc phản hồi chậm
Nền Tảng Phân Tích Log Chuyên Dụng
| Công cụ | Điểm mạnh | Phù hợp với |
|---|---|---|
| Screaming Frog Log File Analyser | Cài đặt local, chi phí hợp lý, dễ bắt đầu | Site vừa và nhỏ, agency quản lý nhiều khách hàng |
| Botify | Log analyzer chuyên sâu, tích hợp dữ liệu crawl và Search Console trong cùng nền tảng | Doanh nghiệp lớn, site có hàng triệu URL |
| Oncrawl | Kết hợp log với dữ liệu crawl và content để phân tích đa chiều | Đội ngũ kỹ thuật SEO chuyên sâu |
| JetOctopus | Xử lý log tốc độ cao, dashboard trực quan dễ đọc | Site thương mại điện tử quy mô lớn |
Trong nhóm nền tảng doanh nghiệp, Botify từng được Forrester xếp hạng là nền tảng duy nhất sở hữu năng lực cốt lõi về log file analysis phục vụ tối ưu crawl budget của Google, và trên G2, người dùng doanh nghiệp đánh giá công cụ log analyzer của Botify thuộc hàng chi tiết nhất họ từng dùng, dù cũng thừa nhận nền tảng này có đường cong học tập khá dốc với người mới.
Xây Dựng Script Phân Tích Tùy Chỉnh
Với những website có log quy mô rất lớn, Python kết hợp BigQuery thường xử lý nhanh hơn nhiều so với các công cụ có sẵn. Cách tiếp cận tùy chỉnh này còn cho phép bạn join dữ liệu log với sitemap và dữ liệu từ Search Console, mở ra những góc nhìn mà công cụ đóng gói sẵn khó làm được.
Cách Phân Tích Log File Cho SEO

Toàn bộ quy trình phân tích log cho SEO có thể gói gọn trong ba bước: truy xuất, xử lý và phân tích.
Truy Cập Log File
Truy cập được log file là điều kiện tiên quyết cho mọi bước phân tích SEO tiếp theo. Nếu bạn chưa lấy được log gốc từ server hoặc CDN, mọi công cụ hay kỹ thuật phía sau đều không có dữ liệu để chạy.
Xuất và Phân Tích Cú Pháp Log File
- Xuất log file thô ra định dạng văn bản hoặc CSV tùy vào công cụ bạn sử dụng
- Parse dữ liệu này thành định dạng bảng, với mỗi cột tương ứng một trường như IP, timestamp, status code
- Chuẩn hóa dữ liệu bằng cách loại bỏ các bot rác và request không liên quan đến SEO, ví dụ request đến file ảnh tĩnh hay tài nguyên CSS
Phân Tích Log File
Sau khi đã có dữ liệu sạch, việc phân tích nên tập trung vào ba chỉ số chính: tần suất crawl theo thời gian, phân bố mã trạng thái và các đường dẫn được request nhiều nhất. Kết quả từ bước này không thay thế mà bổ sung cho một cuộc kiểm tra kỹ thuật SEO toàn diện, giúp bạn xác nhận những gì công cụ audit dự đoán có thực sự diễn ra trên server hay không.
Phân Tích Hoạt Động Của Bot Tìm Kiếm

Sau khi nắm được bức tranh tổng quan, bạn cần đi sâu vào hành vi của từng loại bot cụ thể xuất hiện trong log.
Nhận Diện Các Bot Tìm Kiếm
- Chuỗi user-agent là yếu tố quyết định để xác định loại bot đang truy cập website
- Log file giúp bạn phân biệt rõ ba nhóm: bot tìm kiếm chính thống như Googlebot, bot của các công cụ SEO như Screaming Frog hay Ahrefs, và bot rác không rõ nguồn gốc thường giả mạo user-agent để né tránh bị chặn
Hiểu Mô Hình Crawl Của Googlebot
Googlebot có xu hướng crawl những trang có tần suất thay đổi nội dung cao thường xuyên hơn, vì nhu cầu crawl của Google được tính toán dựa trên độ phổ biến của trang lẫn tốc độ cập nhật nội dung. Về phía Google, đại diện của hãng từng nhiều lần xác nhận rằng crawl budget chủ yếu là vấn đề của những site cực lớn, thường là những site có hơn một trăm nghìn URL hoặc liên tục cập nhật hàng chục nghìn trang mỗi ngày, còn phần lớn website thông thường không cần quá lo lắng về khái niệm này.
Điều đó không có nghĩa log file analysis vô dụng với site nhỏ, mà chỉ giúp bạn đặt đúng kỳ vọng: nếu site của bạn chưa đến ngưỡng đó, vấn đề crawl thường nằm ở chất lượng nội dung hoặc cấu trúc liên kết nội bộ hơn là ở crawl budget.
Phân Tích Crawl Mobile-First
Kể từ ngày 5 tháng 7 năm 2024, Google chính thức hoàn tất quá trình chuyển đổi mobile-first indexing và chỉ còn crawl, index toàn bộ website bằng Googlebot Smartphone. Điều này có nghĩa là nếu log file của bạn vẫn ghi nhận phần lớn request đến từ Googlebot Desktop, đó là dấu hiệu bất thường cần kiểm tra ngay. Với những trang phụ thuộc nhiều vào JavaScript để hiển thị nội dung, bot cần thời gian render trước khi có thể index, và đây cũng là lý do bạn nên đối chiếu thêm với kiến thức về JavaScript SEO khi thấy log cho thấy bot ghé thăm nhưng nội dung vẫn chậm được index.
Chẩn Đoán Các Vấn Đề SEO Thường Gặp Qua Log File

Dữ liệu log không chỉ mô tả hành vi bot, nó còn giúp bạn kết nối trực tiếp với các vấn đề SEO kỹ thuật thường gặp trên website.
Phân Tích Mã Trạng Thái HTTP
| Mã trạng thái | Ý nghĩa | Hành động SEO |
|---|---|---|
| 2xx | Request thành công | Không cần hành động, đây là trạng thái lý tưởng |
| 3xx | Chuyển hướng | Kiểm tra chuỗi redirect, cập nhật internal link để trỏ thẳng đến URL đích thay vì đi qua nhiều bước redirect |
| 4xx | Trang không tồn tại | Chuyển hướng 301 nếu trang còn giá trị, hoặc chấp nhận 404 nếu nội dung thực sự đã biến mất |
| 5xx | Lỗi máy chủ | Kiểm tra hiệu năng server ngay lập tức, vì bot gặp lỗi 5xx liên tục sẽ khiến crawl budget bị cắt giảm |
Log file hiển thị toàn bộ các mã trạng thái mà bot thực sự gặp phải, và tỷ lệ 4xx hoặc 5xx cao trong log là tín hiệu báo động cho thấy có lỗi kỹ thuật cần xử lý ngay.
Xác Định Lãng Phí Crawl Budget
Bot thường lãng phí một phần đáng kể crawl budget vào các URL tham số, trang phân trang và điều hướng lọc sản phẩm. Theo phân tích của Screaming Frog, khoảng 35% crawl budget của một website thương mại điện tử thông thường bị tiêu tốn vào các URL faceted không mang lại giá trị SEO, và con số này có thể vượt quá 60% ở những site quy mô lớn. Cách hiệu quả nhất để phát hiện lãng phí này là so khớp dữ liệu log với sitemap, từ đó bạn sẽ thấy rõ những URL bot đang crawl nhưng thực chất không có giá trị SEO nào.
Tối Ưu Crawl Budget Từ Dữ Liệu Log
Sau khi xác định được nguồn lãng phí, bước tiếp theo là chặn robots.txt hoặc gắn thẻ noindex cho các URL đó, giúp tập trung crawl budget vào những trang thực sự quan trọng. Bạn có thể tìm hiểu sâu hơn về chủ đề này trong bài viết về crawl budget. Bên cạnh việc chặn URL rác, cải thiện cấu trúc internal linking hướng đến các trang ưu tiên cũng giúp tăng tần suất bot ghé thăm những trang đó.
Những Insight Quan Trọng Từ Log File Analysis
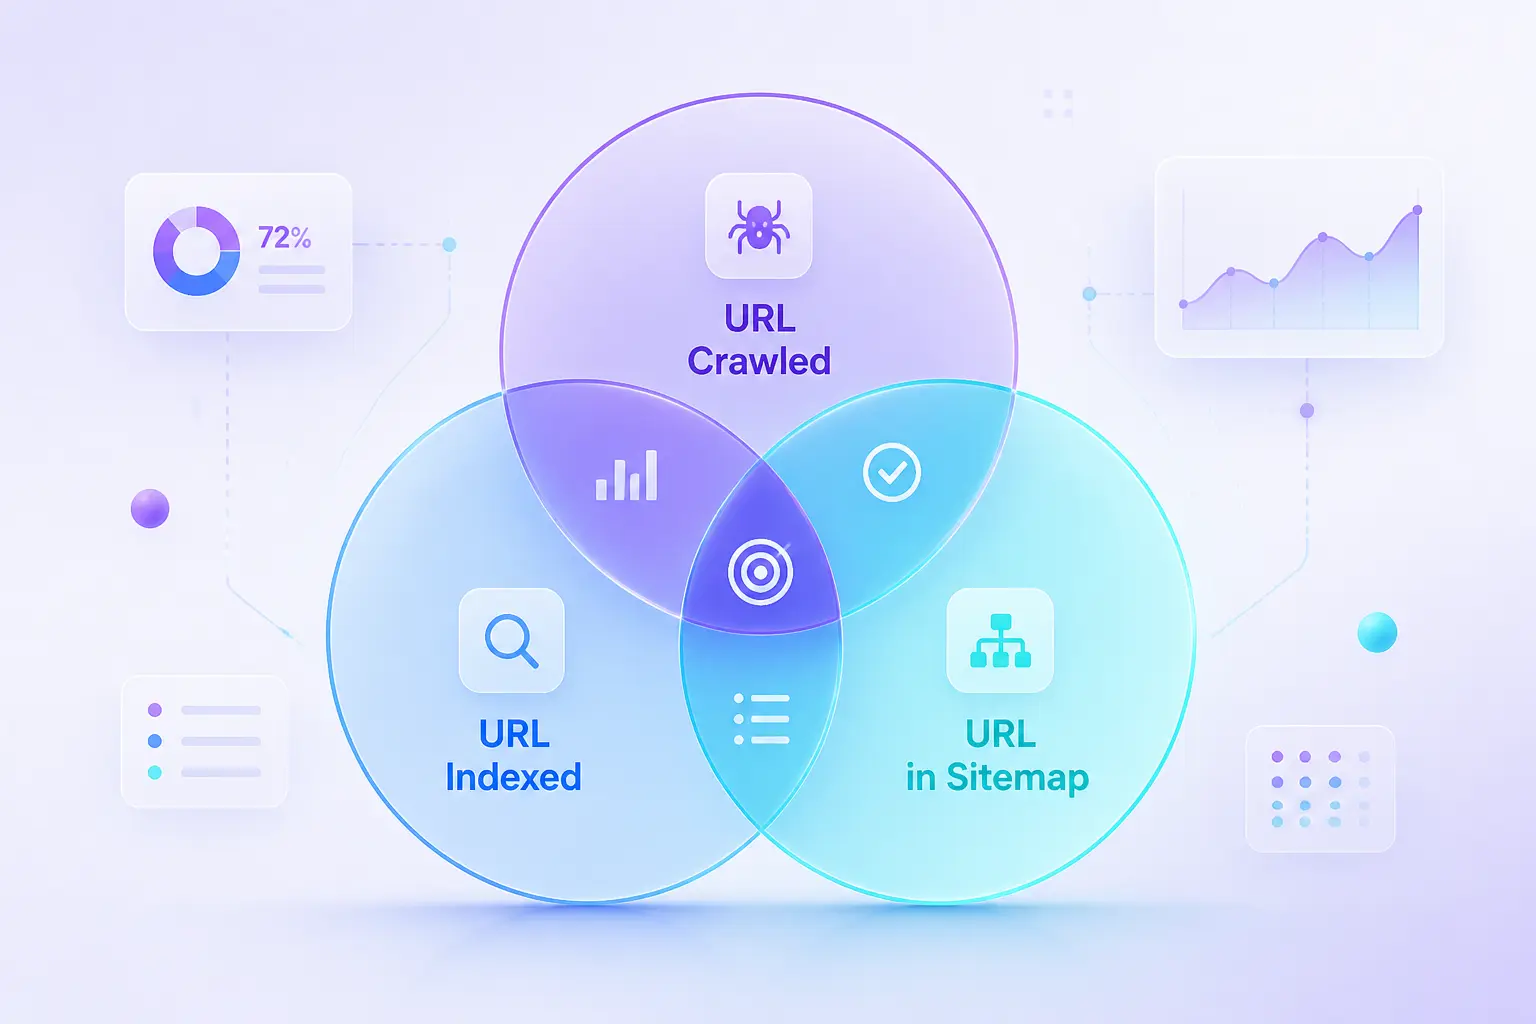
Ngoài việc chẩn đoán lỗi, log file còn cung cấp ba loại insight chiến lược mà không nguồn dữ liệu nào khác có thể thay thế.
Phát Hiện Khu Vực Có Nhiều Lỗi Crawl Nhất
Nhóm lỗi crawl theo thư mục giúp bạn xác định khu vực nào trên website cần được ưu tiên sửa trước. Trên các site thương mại điện tử, thư mục chứa sản phẩm đã hết hàng thường là nơi chiếm tỷ lệ lỗi 404 cao nhất, vì các URL này vẫn tồn tại trong index cũ nhưng không còn được duy trì đúng cách.
Phát Hiện Trang Có Thể Index Nhưng Chưa Được Crawl
So sánh dữ liệu log với sitemap sẽ giúp bạn phát hiện những trang có thể index được nhưng chưa từng xuất hiện trong log, tức là bot chưa từng chạm tới. Nếu một trang mới xuất bản không hề xuất hiện trong log sau một thời gian, đó thường là dấu hiệu cho thấy cấu trúc internal linking đến trang đó còn yếu.
Phát Hiện Trang Mồ Côi
Trang mồ côi là những trang tồn tại trên website nhưng không có bất kỳ liên kết nội bộ nào trỏ tới. Cách chính xác nhất để xác định chúng là kết hợp dữ liệu log với dữ liệu crawl từ một công cụ crawler, vì log cho biết trang đó có được bot ghé thăm hay không, còn crawler cho biết trang đó có được liên kết nội bộ trỏ đến hay không.
Xây Dựng Quy Trình Phân Tích Log File
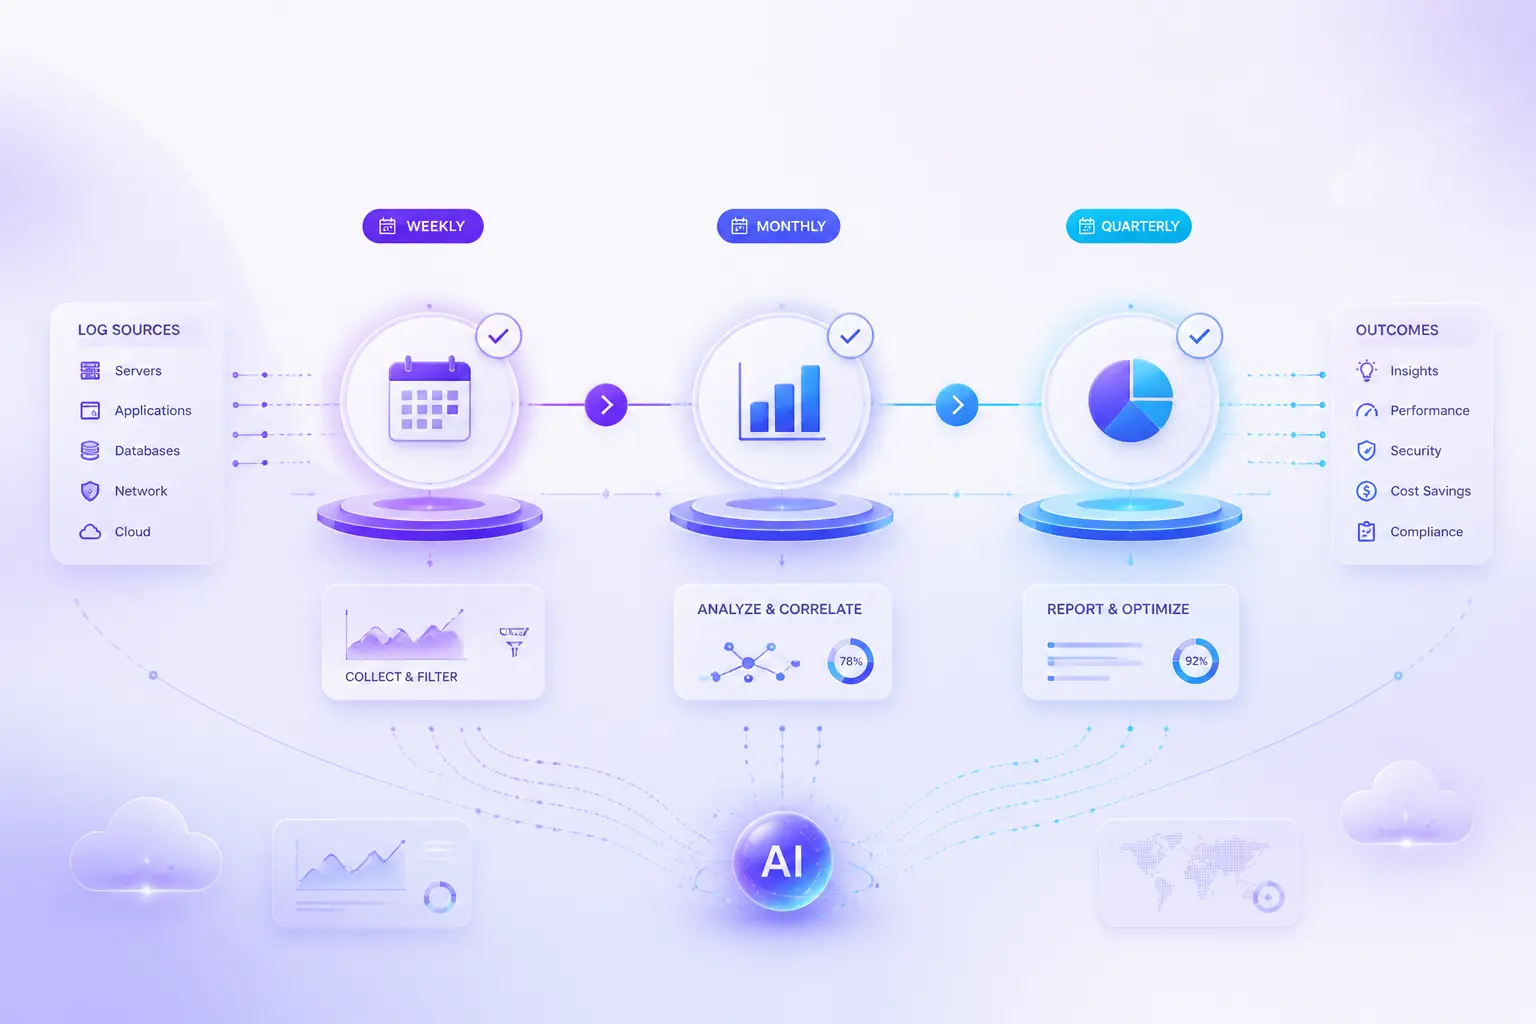
Những insight rời rạc sẽ có giá trị thực sự khi bạn biến chúng thành một quy trình lặp lại có hệ thống theo thời gian.
Kiểm Tra Nhanh Hàng Tuần
- Tập trung vào các mã lỗi mới phát sinh và những bot lạ vừa xuất hiện trong log
- Theo dõi crawl rate của Googlebot theo tuần để phát hiện sự sụt giảm bất thường càng sớm càng tốt
Phân Tích Sâu Hàng Tháng
- Đối chiếu dữ liệu log với sitemap và Google Search Console để tìm khoảng cách giữa các nguồn dữ liệu
- Lập báo cáo hàng tháng để xác định xu hướng crawl budget theo từng loại trang trên website
Đánh Giá Chiến Lược Hàng Quý
- So sánh hiệu quả crawl trước và sau khi thực hiện các thay đổi kỹ thuật để đo lường tác động thực tế
- Dùng dữ liệu log dài hạn làm căn cứ để điều chỉnh kiến trúc site nếu cần thiết
Xác Minh Googlebot Thật (Kiểm Tra Reverse DNS)
Một vấn đề dễ bị bỏ qua khi đọc log là chuỗi user-agent hoàn toàn có thể bị giả mạo. Bất kỳ bot rác hay công cụ scraping nào cũng có thể tự khai mình là Googlebot trong request, khiến số liệu crawl của bạn bị sai lệch nếu chỉ dựa vào user-agent. Cách xác minh chính thức mà Google khuyến nghị là chạy reverse DNS lookup trên địa chỉ IP nguồn trong log, sau đó kiểm tra xem tên miền trả về có kết thúc bằng googlebot.com, google.com hoặc googleusercontent.com hay không. Tuy nhiên, chỉ dừng lại ở đó là chưa đủ, vì kẻ giả mạo hoàn toàn có thể tự cấu hình bản ghi PTR trỏ về một tên miền giả trông giống googlebot.com. Bước xác nhận bắt buộc còn lại là chạy tiếp forward DNS lookup trên tên miền vừa nhận được, và chỉ khi kết quả trả về đúng địa chỉ IP ban đầu thì request đó mới thực sự đến từ Googlebot. Với site có lượng request lớn, bạn nên lọc trước theo dải IP mà Google công bố chính thức để tránh phải chạy DNS lookup cho từng dòng log, vốn là thao tác tốn tài nguyên nếu thực hiện ở quy mô lớn.
Kết Luận
Log file analysis không phải là một kỹ thuật thay thế cho crawl audit hay Google Search Console, mà là mảnh ghép còn thiếu giúp bạn nhìn thấy sự thật đằng sau những gì Googlebot thực sự làm trên website của bạn. Hành trình từ truy xuất log, làm sạch dữ liệu, phân tích tần suất crawl, cho đến xác minh tính xác thực của bot, tất cả đều hướng đến một mục tiêu duy nhất: giúp crawl budget của bạn được dùng đúng chỗ, đúng lúc. Nếu bạn xây dựng được một quy trình kiểm tra định kỳ, từ kiểm tra nhanh hàng tuần đến đánh giá chiến lược hàng quý, log file sẽ dần trở thành nguồn dữ liệu đáng tin cậy nhất trong bộ công cụ SEO kỹ thuật của bạn.